
大语言模型是什么:它不是搜索框,而是会续写和推理的语言系统
讲清大语言模型的基本概念、Token、预训练、指令微调、上下文窗口和可靠性边界。
相关工具
文章目录(7 个章节)
先把大语言模型放回“语言”这件事里
很多人第一次接触大语言模型,是从 ChatGPT、DeepSeek、通义、豆包这类聊天界面开始的。它能回答问题、写文章、翻译、总结 资料、改代码,甚至能像一个懂行的人一样解释复杂概念。于是很容易把它理解成一个更聪明的搜索框,或者一个装了很多知识的问答库。这个理解方便入门,但不够准确。
LLM 全教程总结里对基础语言模型的解释很朴素:模型最开始学到的是根据已有文本预测下一个词或下一个片段的能力。你给它一句“从前,有一只独角兽”,它会根据训练中见过的大量文本模式,继续生成后面的内容。大语言模型的“大”,主要体现在参数规模、训练数据规模和计算规模上;它的“语言”,则体现在它把文字当作输入和输出的主要形式。
所以,大语言模型不是先在脑子里查一个答案,再把答案拿出来。更接近的说法是:它把你的输入拆成一段可计算的序列,结合上下文,在每一步预测接下来最合适的 token,然后不断生成,直到形成一段完整回答。它之所以看起来会解释、会写作、会推理,是因为训练规模足够大之后,语言规律、知识片段、任务格式和推理步骤被压进了模型参数里。
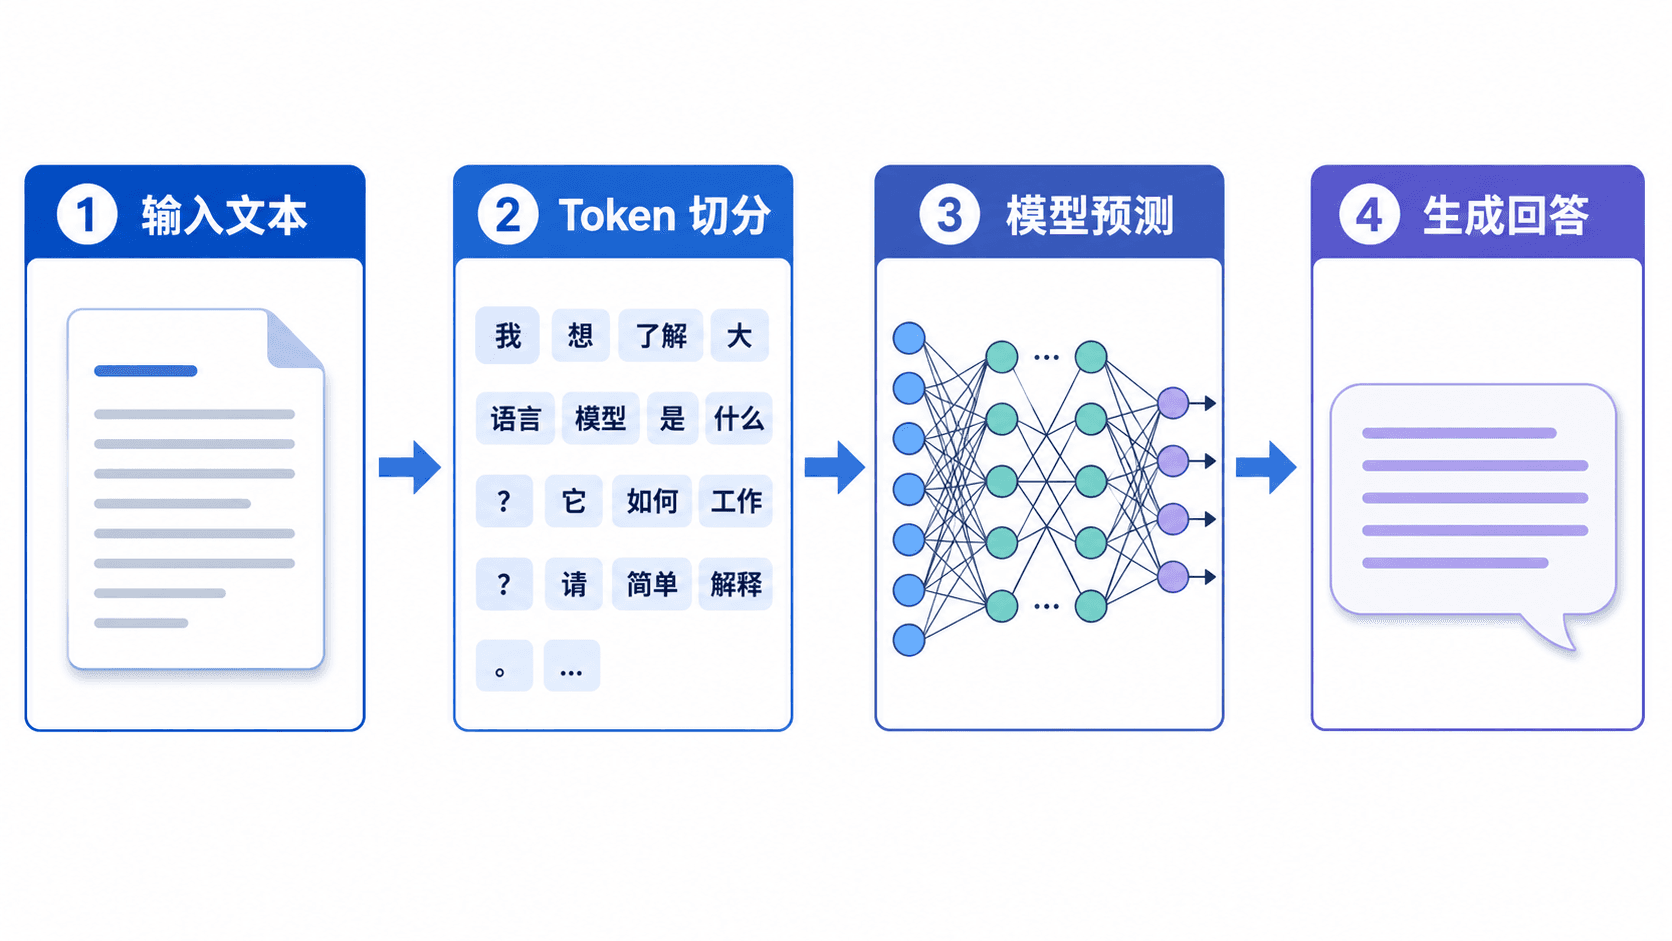
大语言模型会先把文本切成 token,再根据上下文逐步预测后文,最后组成一段可读回答。
Token 是模型真正读到的单位
人读一句话时,看到的是字、词、标点和语气。模型不能直接按人的方式阅读,它会先把文本切成 token。大语言模型基础与实践学习笔记把 Tokenization 放在整体架构开头讲,原因就在这里:分词不是边角知识,而是模型处理语言的入口。
Token 可以是一个字、一个词、一个子词,也可能是一段符号。英文里常见单词会被保留,生僻词会被拆成更小的子词;中文因为没有天然空格,也会按分词器的规则切成不同片段。资料里提到,子词粒度能在词表大小和语义表达之间取得平衡,BPE、WordPiece、Unigram 这类算法都在解决类似问题:既不要让词表大到难以训练,也不要把文本切得太碎。
理解 token 有两个好处。第一,你会明白为什么同样一段内容,在不同模型里消耗的 token 数可能不同。分词器越适合某种语言或代码形式,表达同样内容可能越省。第二,你会明白模型为什么偶尔不擅长拼写、反转字符串、简单算术或处理奇怪符号。它看到的不是完整的人类字符序列,而是分词器切出来的片段。很多看似简单的文字操作,对模型来说并不天然简单。
预训练让模型学会“接着说”
基础大语言模型的第一阶段通常是预训练。它会在大规模文本语料上学习语言规律,目标可以简单理解为预测下一个 token。这个任务看起来单调,但规模放大后很强。模型为了预测后文,必须学习词语搭配、语法结构、事实关联、代码模式、问答格式、论证方式,甚至一些隐含的世界知识。
LLM 全教程总结里举过一个很直观的区别:基础 LLM 看到“法国的首都是什么”时,不一定直接回答“巴黎”,它可能继续生成类似网页问答列表的内容,因为它学到的是续写文本,而不是天然服从指令。这个例子很适合提醒新手:基础模型不是天生的助手。它更像一个在海量文字中学会续写的人,能接下去写,但不一定知道你希望它按问答方式完成任务。
预训练的价值在于打底。没有这一步,模型就没有足够的语言能力和常识背景;只有这一步,模型又可能不够听话。今天我们习惯使用的聊天模型,往往是在预训练模型的基础上继续做了指令微调、偏好对齐和安全训练,才变得更像一个能理解任务的助手。
指令微调让模型更像助手
当你问“请用三句话解释什么是 RAG”,现在的模型通常会按要求回答,而不是继续写一段网络文章。这背后离不开指令微调。LLM 全教程总结把基础 LLM 和指令微调 LLM 分开讲:基础模型主要学习预测后续文本,指令微调模型则通过专门数据学习如何理解并遵循人的要求。
可以把这个过程想成两步。第一步,预训练让模型读过大量语言材料,知道世界上大概有哪些表达方式。第二步,指令微调给它看很多“指令-回答”样本,让它学会用户说“总结、翻译、提取、改写、列步骤”时应该怎么回应。之后再通过人类偏好数据或类似方法,让模型更倾向于输出有帮助、清楚、合规的答案。
这也是为什么同样叫大语言模型,不同模型用起来差别很大。有的更擅长写作,有的更擅长推理,有的更适合代码,有的更会遵循格式。底层语言能力是一回事,后训练和对齐方式又是另一回事。真正选模型时,不能只看参数大小,也要看它针对什么任务调过、是否适合你的使用场景。
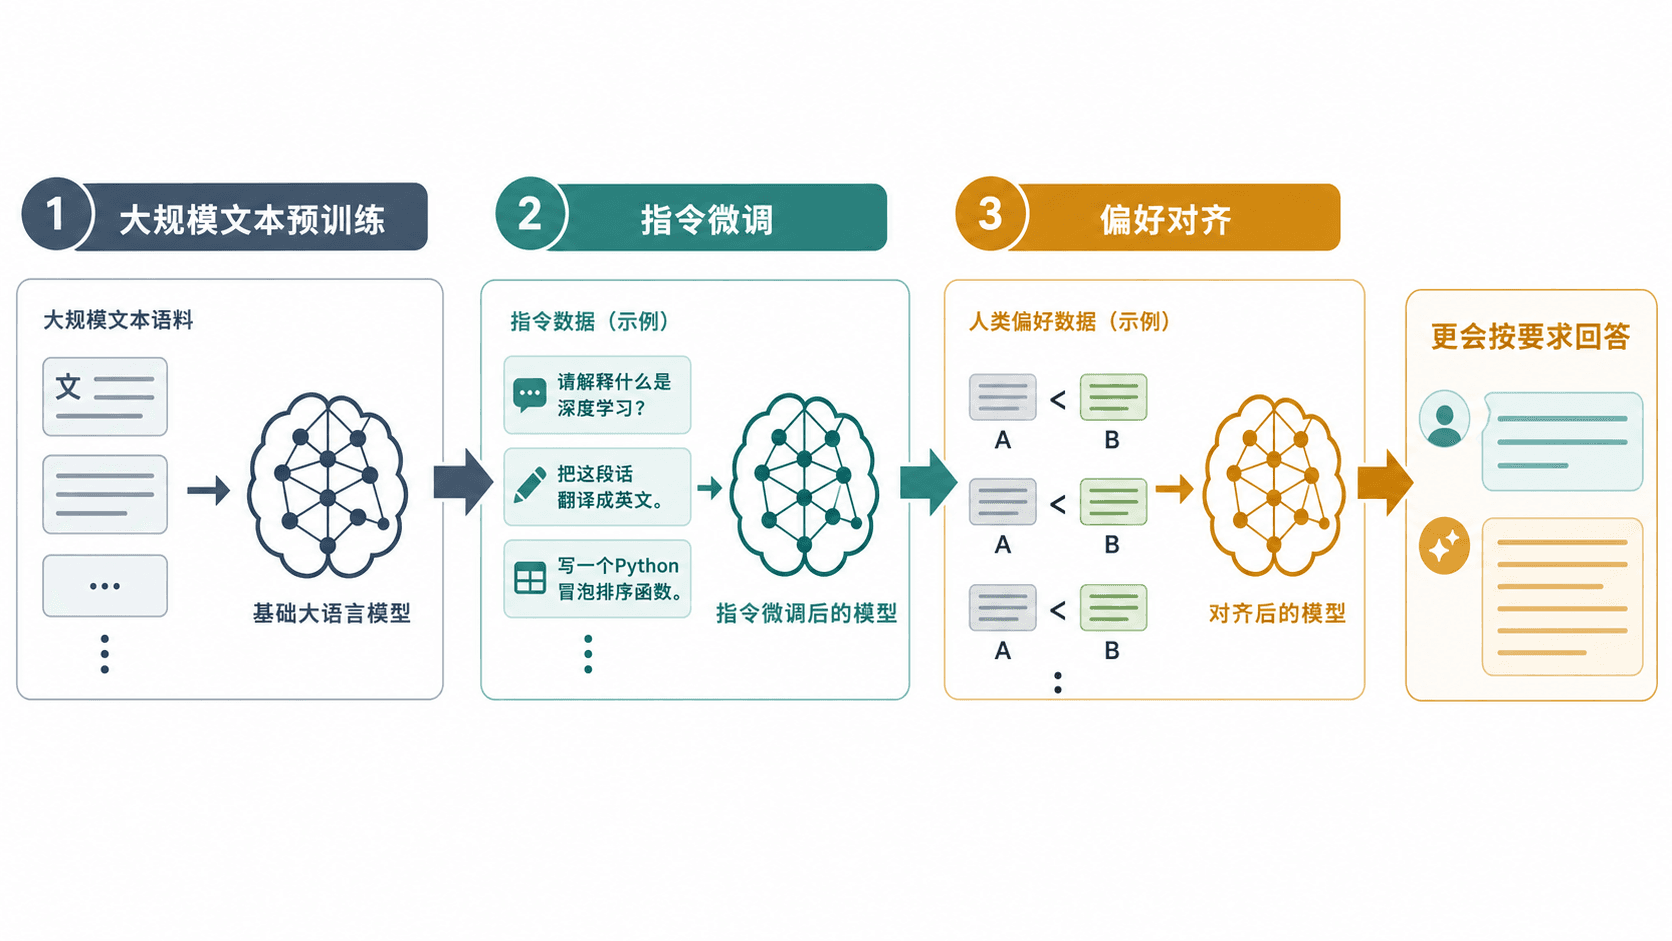
预训练解决语言能力,指令微调解决任务遵循,偏好对齐让模型更接近人希望看到的回答方式。
上下文窗口决定它这次能看到多少材料
使用大语言模型时,还有一个绕不开的概念:上下文窗口。你在对话里输入的问题、粘贴的资料、前面的聊天记录、系统提示和模型已经生成的内容,都会占用上下文。窗口越大,一次能放进去的材料越多;窗口不够,前面的内容就可能被截断或压缩。
这和人类记忆不太一样。模型不是永久记得你在所有对话里说过什么。对一次回答来说,它主要依赖当前上下文里的内容,以及训练时已经写进参数的知识。如果你把一份 资料 发给它,它能利用的是这次上下文中被放进去的文字;如果资料太长,没有被检索或切分到上下文里,它就不能凭空引用那一页。
这也是 RAG 和知识库存在的原因。通用模型无法自动知道你的私有资料,也不会天然跟着公司制度更新。更稳的做法是把资料加载、切分、向量化、检索,然后把与问题相关的片段放进上下文,让模型基于材料回答。模型负责组织语言,资料负责提供事实。两者分工清楚,答案才更容易追溯。
为什么它会一本正经地答错
大语言模型的回答常常很流畅,这既是优点,也是风险。它学会了很多自然语言里的表达模式,能把答案写得像一篇完整说明。但流畅不等于正确。资料里反复强调,模型的能力来自训练数据、提示词和上下文,当前主流模型对私有数据、实时数据和未提供资料并没有天然访问能力。
当问题超出上下文,或者训练中学到的模式不足以支撑准确答案时,模型可能会补出一个看起来合理的说法。这就是大家常说的幻觉。它不一定是故意乱说,而是生成机制本身会倾向于继续给出最像答案的文本。对写作润色来说,这种能力很有用;对事实核查、合同条款、医疗金融建议、代码变更来说,就必须谨慎。
判断一段 AI 回答能不能用,不能只看它语气是否肯定。要看它有没有来源,关键数字和术语是否能核对,是否把假设说成事实,是否考虑了边界条件。重要内容最好让模型列出依据,再由人核查原文。
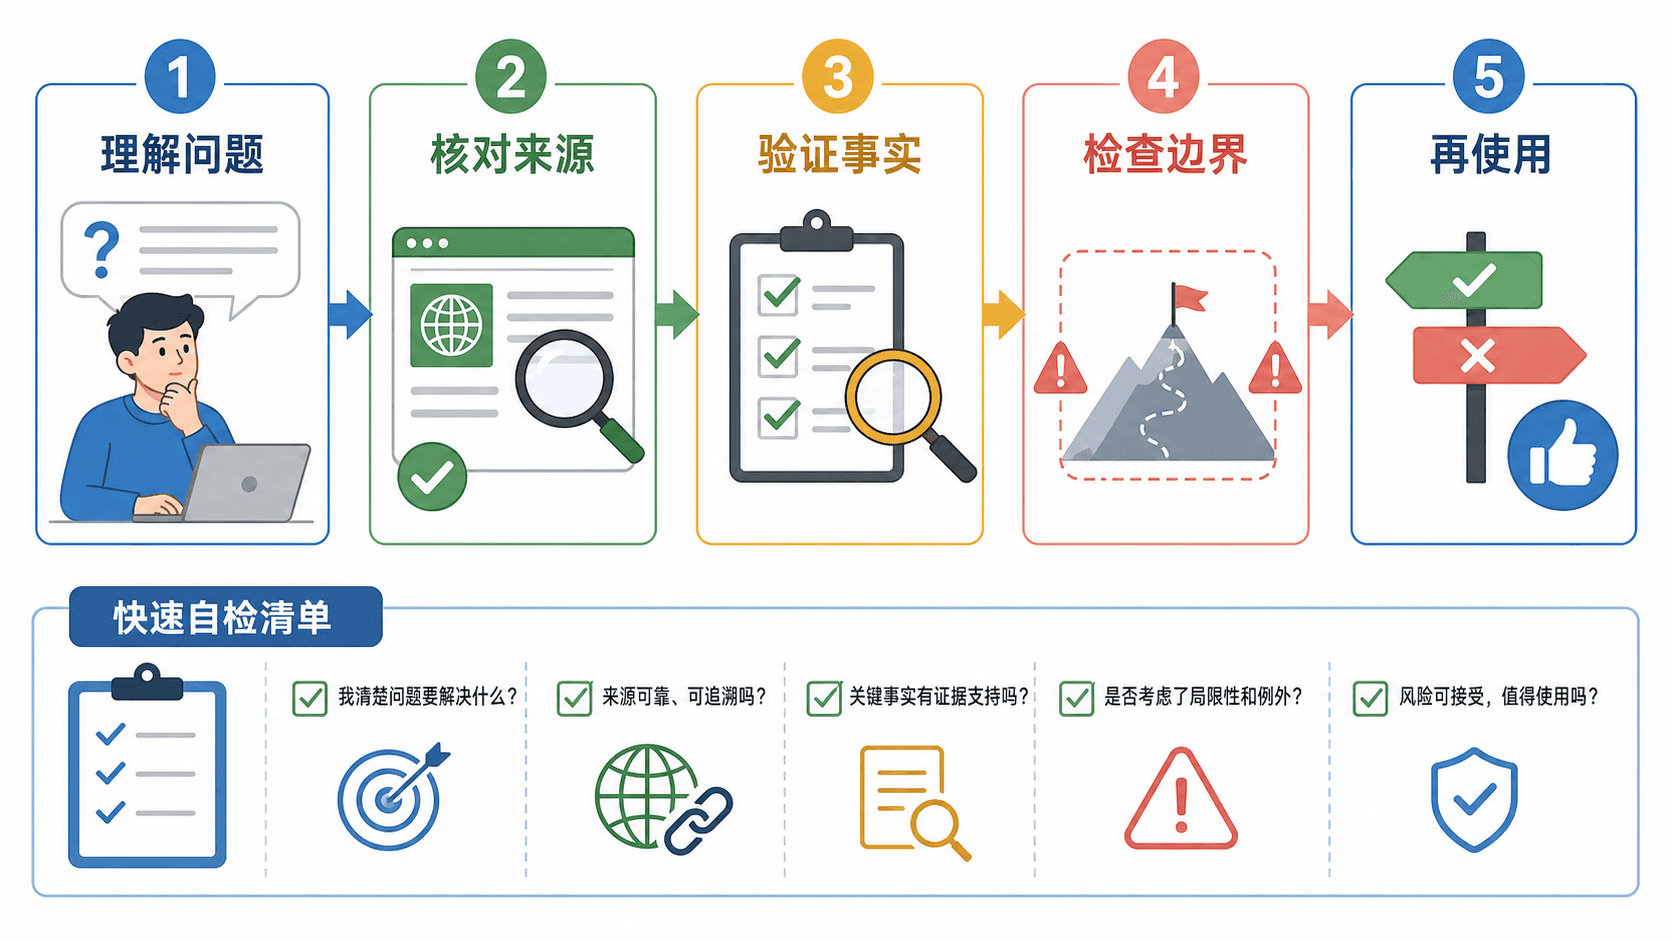
先确认问题、来源、事实和边界,再决定是否把答案用于正式场景。
普通人应该怎样理解它的价值
对普通使用者来说,不必一开始就钻进训练公式。先抓住三句话就够了。第一,大语言模型是一个基于大量文本训练出来的语言系统,核心能力是根据上下文生成合适的后文。第二,今天好用的聊天模型通常不只是基础模型,还经过指令微调和对齐训练,所以更会按要求回答。第三,它很强,但不是事实数据库,重要结论必须有资料依据和人工复核。
有了这个理解,再去学 Prompt、RAG、Agent、DeepSeek 职场应用,就不会被花哨名词带着走。Prompt 是把任务说清楚,减少模型猜测;RAG 是把外部资料检索进上下文,让回答有依据;长期记忆是把有价值的信息沉淀下来,下次再用;模型评估是看答案是否稳定、准确、可追溯。
大语言模型最适合承担的是语言和知识加工工作:整理、归纳、改写、解释、生成草稿、辅助分析。它不适合在缺资料时替你拍板,也不适合把风险很高的决定完全交出去。把它当成一个能力很强但需要材料、边界和复核的助手,通常比把它当成全知机器更接近真实。
常见问题
大语言模型和搜索引擎有什么区别?
搜索引擎主要帮你找到网页和资料,大语言模型主要根据上下文生成回答。它可以解释和组织内容,但如果没有检索或资料输入,不一定知道最新或私有信息。
为什么大模型要先把文字切成 Token?
模型不能直接按人的阅读方式处理文本,需要先用分词器把文本切成可计算的 token 序列。Token 的切分方式会影响上下文长度、成本和一些文字任务的表现。
大语言模型回答得很肯定,就代表一定正确吗?
不代表。流畅和肯定只是生成效果,事实是否正确还要看来源、上下文和可验证证据。重要内容应核对原文或权威资料。