
TCP 粘包和拆包:为什么一次读取不等于一条消息
围绕TCP 粘包拆包章节,讲清 TCP 字节流、Socket 缓冲区、MSS、Nagle 算法与应用层消息边界设计。
相关工具
文章目录(9 个章节)
先纠正一个容易误会的说法
很多资料会把这个问题叫作“TCP 粘包”,听起来像 TCP 把包处理错了。更准确地说,TCP 没有做错事,出问题的是应用层把一次 `read` 或 `recv` 误当成了一条完整业务消息。
资料 在粘包拆包章节里先强调了一点:TCP 是流协议。流没有天然边界,它更像一长串连续的二进制数据。应用层写入时可能是一条消息一条消息地写,接收端读出来时却只看到字节流。TCP 负责把字节可靠、有序地送到对方,至于哪些字节算一条订单、一次登录请求、一个聊天消息,它并不知道。
所以,理解粘包拆包的关键不是背结论,而是换一个视角:业务层看到的是“消息”,TCP 层看到的是“字节”。只要应用层协议没有清楚标出消息边界,接收端就没有可靠依据判断这一段字节该从哪里切开。
粘包和拆包到底是什么
所谓拆包,是应用层认为的一条完整消息,被接收端分成了多次才读到。比如客户端写入一条 10 KB 的业务数据,服务端第一次只读到前 4 KB,第二次读到中间 4 KB,第三次才读到剩下的 2 KB。如果服务端把第一次读取结果直接当成完整消息解析,就会得到半条数据。
所谓粘包,是应用层认为的多条消息,在接收端一次读取里连在了一起。比如客户端连续发送“消息 A”“消息 B”“消息 C”,服务端一次 `recv` 读到了 A 和 B 的全部内容,甚至又带上了 C 的开头。如果服务端只按“一次读取就是一条消息”处理,就会把两条消息误拼成一条。
这两种现象经常同时出现。今天读到半条,明天读到两条半,本质上都是同一个问题:TCP 只交付字节流,不交付业务消息边界。
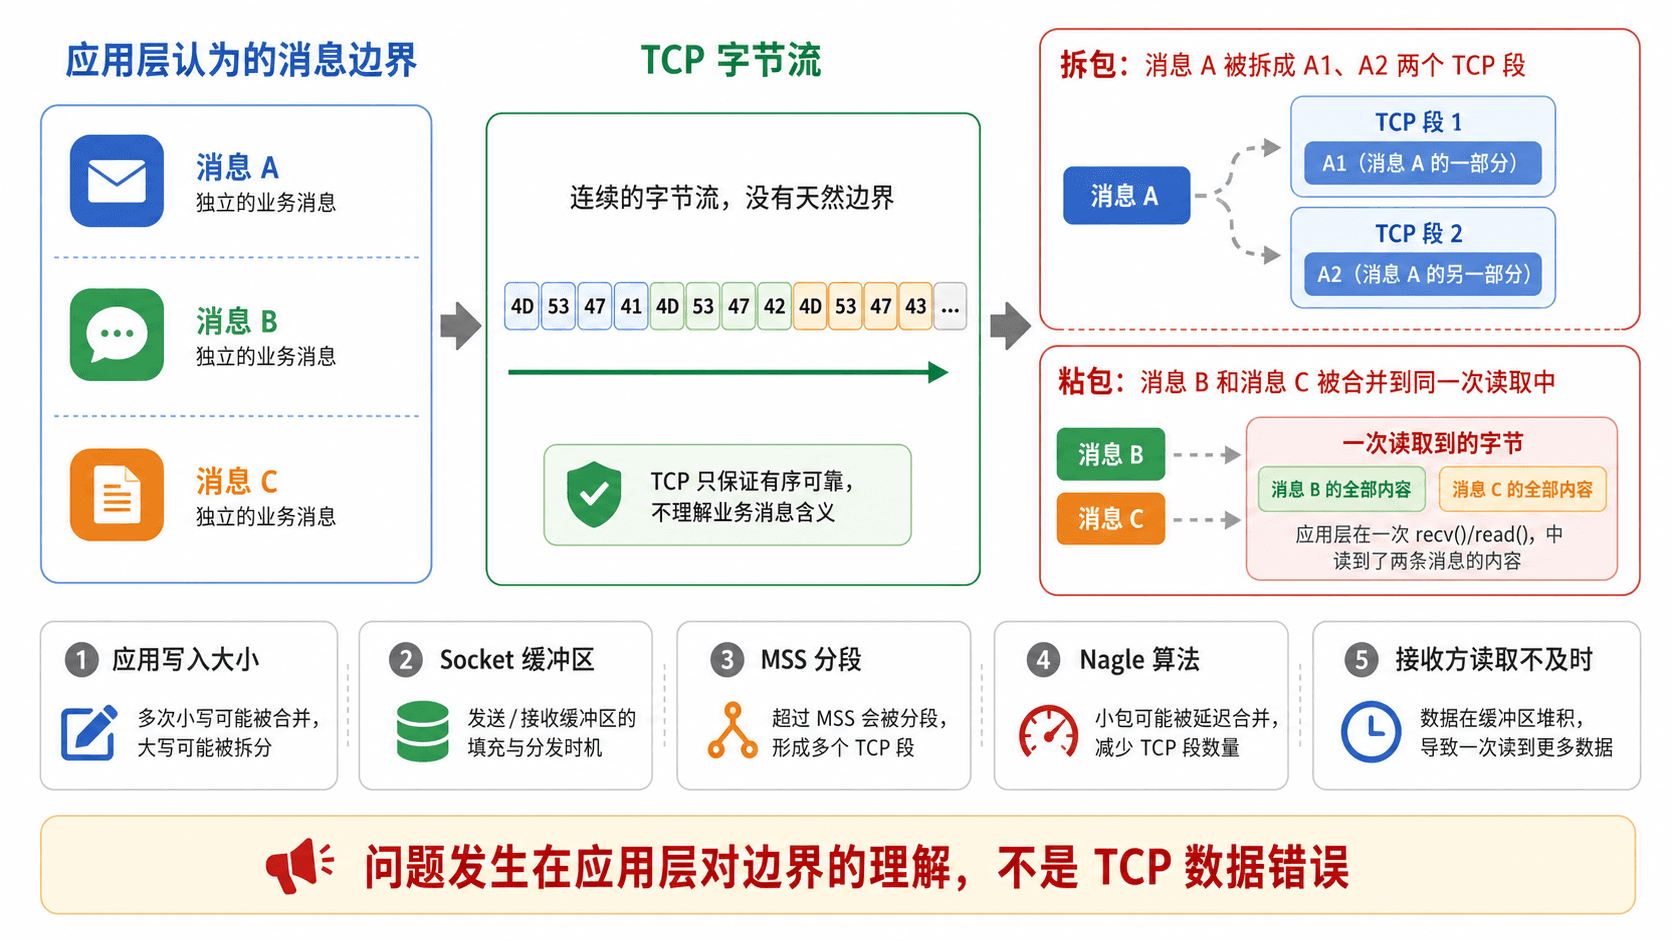
应用层按消息组织数据,TCP 层按连续字节流传输。一次读取可能只拿到半条消息,也可能拿到多条消息。
为什么会发生:缓冲区、MSS 和读取时机
已有的原因很具体。第一,应用程序写入的数据大于 Socket 发送缓冲区,系统可能分多次发送,接收端自然也可能分多次读到。第二,应用程序写入的数据很小,多次写入的数据可能在发送缓冲区或网卡层面被合并后再发出去,于是接收端一次读到了多条消息。
第三,TCP 报文段有长度限制。前面讲 MTU 和 MSS 时已经提到,以常见以太网 MTU 1500 字节为例,扣掉 IP 头和 TCP 头后,TCP 载荷的 MSS 常见值约为 1460 字节。业务消息如果大于 MSS,就会被拆成多个 TCP 段发送。这个分段对 TCP 来说很正常,对应用层来说却不能直接等同于一条消息。
第四,接收端读取也有时机问题。数据到达后会先进入接收缓冲区,应用程序什么时候读、一次读多少,并不由发送端决定。如果接收端处理慢,缓冲区里可能已经积累了多条消息;如果接收端读得早,也可能只读到一条消息的一部分。
Nagle 算法只是影响发送,不负责分消息
同时提到 Nagle 算法。它的目的很朴素:减少网络里过多的小 TCP 段。很多程序会频繁写入很小的数据,如果每次都立刻发出去,包头开销会很高,网络也容易被小包占满。Nagle 算法会把一些小数据先合并,等条件合适再发送。
这也是为什么长连接里更容易遇到粘包。连接一直开着,客户端和服务端会持续写入和读取,多个业务消息天然有机会挤在同一段字节流里。短连接场景下,每次连接只处理一次请求和响应,问题不那么明显;而像自定义 TCP 协议、IM 长连接、游戏服务、网关转发、数据库连接这类场景,应用层协议必须认真处理边界。
`TCP_NODELAY` 可以关闭 Nagle 算法,减少发送端合并小包带来的延迟。但它不是粘包拆包的根治方案。即使关闭 Nagle,MSS 分段、发送缓冲区、接收缓冲区、应用读取时机仍然存在。只靠它,接收端还是无法知道一条业务消息在哪里结束。
HTTP 为什么通常不用这样处理
有些同学会问:HTTP 也是跑在 TCP 上,为什么我们平时写 HTTP 接口很少处理粘包?原因是 HTTP 自己已经定义了清楚的应用层边界。请求行、响应行、Header、空行、`Content-Length`、分块传输编码,这些规则共同告诉接收端:头部在哪里结束,正文该读多少。
也就是说,HTTP 并没有逃离 TCP 字节流,它只是把“怎么分消息”这件事写进了协议。浏览器、服务器框架、代理服务器都会按 HTTP 协议解析字节流,业务代码拿到的已经是被框架处理好的请求对象和响应对象。
自定义 TCP 服务没有这层现成规则,就要自己补上。很多线上问题不是网络真的丢了数据,而是协议设计偷懒,接收端按一次读取解析一条消息,遇到高并发、慢消费、跨机房网络后才暴露出来。
正确做法:在应用层定义边界
解决粘包拆包,核心就是让应用层协议能识别一条完整消息。文中给了两个方向:一种是包头加包长加包体,另一种是指定结束标识。工程里常见做法还包括固定长度消息,它适合内容格式简单、长度固定的场景。
固定长度最容易实现。比如每条消息固定 128 字节,接收端每凑够 128 字节就取出一条。但它浪费空间,也不适合变长正文。长度字段更常用:先读固定长度的包头,从包头里拿到包体长度,再继续读取指定长度的包体。很多二进制协议都会这么设计。
分隔符方案也常见,比如按换行符、CRLF 或自定义结束符切分。它读起来直观,适合文本协议和日志流,但要处理正文里出现分隔符的情况。要么正文禁止出现该字符,要么做转义,要么使用更严格的编码规则。
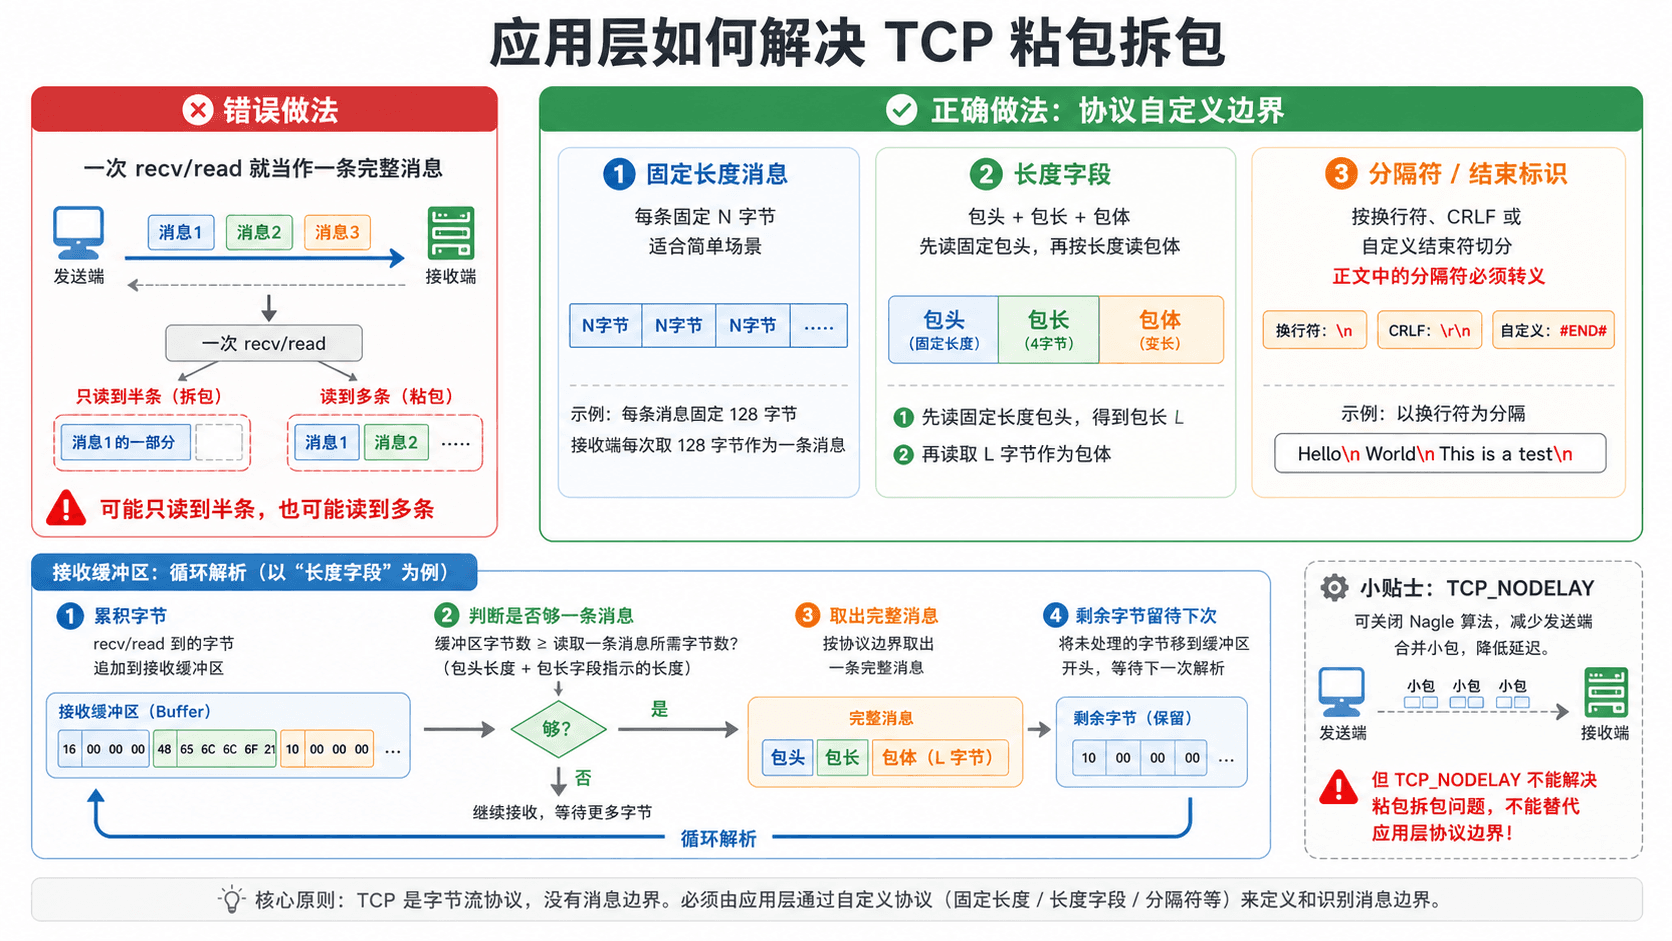
一次读取不能直接等于一条消息。接收端应该累积缓冲区,并根据固定长度、长度字段或分隔符循环解析完整消息。
接收端要做循环解析
更稳的接收逻辑通常不是“读一次,解析一次”,而是“读到多少先放进缓冲区,再尝试从缓冲区里解析完整消息”。如果缓冲区里的字节还不够一条消息,就继续等待下一次读取;如果够一条,就取出来交给业务层处理;如果取出一条后还有剩余字节,就把剩余部分留在缓冲区,下次继续解析。
以长度字段方案为例,接收端先判断缓冲区是否至少有固定包头。如果连包头都不够,就继续读。包头够了以后解析出包体长度,再判断缓冲区是否已经有“包头长度 + 包体长度”这么多字节。如果不够,继续读;如果够,取出完整消息,移动读取位置,然后尝试解析下一条。
这里还要加一些保护。包体长度不能无限大,否则恶意客户端只要声明一个超大长度,就可能拖垮内存。协议还要规定字节序、编码方式、压缩方式、校验字段和版本号。粘包拆包看似是网络问题,最后往往会落到协议设计和健壮性上。
调试时怎么判断是不是边界问题
如果一个 TCP 服务偶尔解析失败,先别急着怀疑系统把数据传坏了。可以从日志里打印每次读取到的字节数、缓冲区累计长度、当前解析出的包长、剩余未处理字节。只要看到一次读取里包含多条业务消息,或者一条消息分好几次才凑齐,就能确认是边界处理问题。
测试时不要只测“一次发送一条、一次读取一条”的理想情况。可以故意把一条消息拆成多次写入,也可以一次写入多条消息,还可以随机切片,把一段完整数据按随机长度分批喂给解析器。真正可靠的解析器,不应该依赖 TCP 每次刚好按业务消息切好。
线上排查还可以结合抓包。抓包能看到 TCP 段怎样分布,但不要把抓包里的一个 TCP 段直接理解成业务包。应用最终读到什么,仍然受缓冲区和读取时机影响。抓包用来辅助定位,应用层协议解析日志才是判断业务边界的主要依据。
面试里怎么讲
如果被问 TCP 粘包拆包,可以先把概念说准:TCP 是面向字节流的可靠传输协议,它不保留应用层消息边界,所以接收端一次读取可能读到半条消息,也可能读到多条消息。
然后解释原因:应用写入大小、Socket 发送和接收缓冲区、MSS 分段、Nagle 算法、接收端读取不及时,都会让发送边界和读取边界不一致。这里不要把现象说成 TCP 错误,TCP 只是按自己的职责传输字节。
最后说解决办法:由应用层协议定义边界。常见方案有固定长度、长度字段、分隔符或结束标识;接收端维护缓冲区,循环判断是否够一条完整消息,够了就取出,不够就继续等待。`TCP_NODELAY` 可以减少小包合并和延迟,但不能替代协议边界。这样回答,比只背“粘包用包头包体解决”要扎实得多。
常见问题
TCP 粘包是 TCP 的 bug 吗?
不是。TCP 本来就是字节流协议,不负责保存应用层消息边界。所谓粘包拆包,是应用层没有正确处理字节流边界时看到的现象。
关闭 Nagle 算法就能彻底解决粘包吗?
不能。`TCP_NODELAY` 只能减少发送端小包合并和部分延迟,不能改变 TCP 字节流的本质,也不能替代应用层协议里的长度字段或结束标识。
最常用的处理方案是哪一种?
变长业务消息里最常见的是“包头 + 长度字段 + 包体”。接收端先读固定包头,再按长度字段读取包体,并把剩余字节留在缓冲区继续解析。