
Redis 缓存雪崩、击穿、穿透:三个问题别再混着答
Redis 缓存异常章节,讲清缓存雪崩、缓存击穿、缓存穿透的触发条件、请求路径、数据库压力来源,以及随机过期时间、互斥锁、后台更新、限流熔断、空值缓存和布隆过滤器等处理办法。
相关工具
文章目录(12 个章节)
先把三个问题分开
Redis 常被放在数据库前面做缓存层。文中说,当用户访问数据库的请求数量比较多时,数据库很容易崩溃,所以一般会把 Redis 作为数据库的缓存层。缓存命中时,请求在 Redis 里结束;缓存没命中时,请求才回到数据库。
问题也出在这里。缓存一旦没有挡住请求,数据库压力就会被放大。缓存雪崩、缓存击穿、缓存穿透这三个词经常一起出现,但它们的触发条件不一样。雪崩是大量 key 同时失效,或者 Redis 故障;击穿是某个热点 key 过期;穿透是请求的数据缓存里没有,数据库里也没有。
如果这三个问题混着答,解决方案也会混。雪崩要分散过期时间、限流熔断、建设高可用;击穿要保护热点 key 的重建过程;穿透要拦掉根本不存在的数据请求。先把问题边界拆清楚,后面的方案才不会乱。
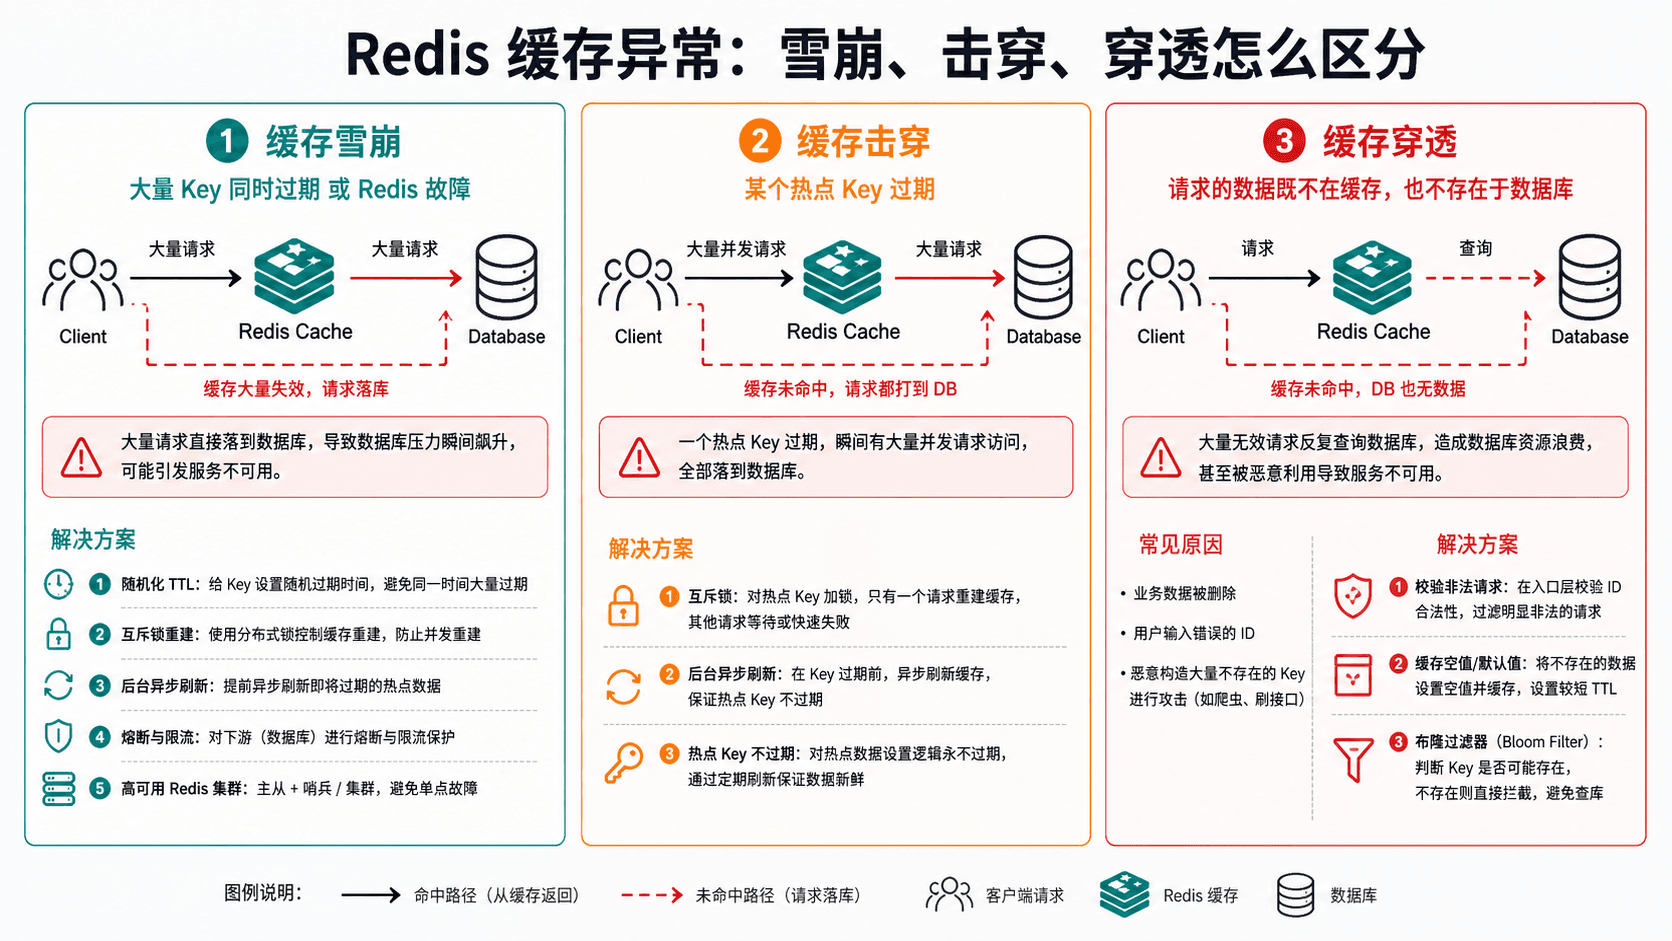
雪崩是大量缓存同时失效或 Redis 故障,击穿是热点 key 过期,穿透是缓存和数据库都没有数据;三者都会把压力推向数据库,但治理入口不同。
缓存雪崩:大面积缓存一起失效
资料 对缓存雪崩的定义是:在某个时间点,缓存中的大量数据同时失效,大量请求都需要重新计算或重新获取数据,数据库压力剧增。它还补了一种情况:Redis 故障宕机,也可能引发类似雪崩的问题。
雪崩的核心不是某一个 key 热,而是“挡在数据库前面的缓存层大面积失效”。比如一次活动把几万条商品缓存都设置成同一个过期时间,到了整点一起过期。原来这些请求都命中 Redis,现在突然全部落到数据库,数据库连接、查询和磁盘 I/O 都会被打满。
Redis 宕机导致的雪崩更直接。缓存层整个不可用,请求没有 Redis 可查,只能大量打到数据库。如果系统没有限流、熔断或降级,数据库可能跟着被拖垮,最后就不是缓存服务不可用,而是整个链路不可用。
雪崩的第一种处理:过期时间打散
已有的第一个办法是均匀设置过期时间:避免大量数据设置成同一个过期时间,可以给这些数据的过期时间加一个随机数。这个办法简单,但很实用。
比如你本来想把一批缓存都设置成 30 分钟过期,可以改成 30 分钟加 0 到 5 分钟的随机值。这样 key 不会在同一秒集中失效,请求回源也会被摊开。数据库仍然会承接未命中的请求,但压力不会突然堆成一个尖峰。
这类策略适合大批量预热、大批量写缓存、定时任务刷新缓存的场景。凡是“批量写入同一类缓存”的地方,都要想一下过期时间是否过于整齐。缓存系统里,过于整齐有时反而危险。
雪崩的第二种处理:互斥锁和后台更新
同时提到互斥锁:如果发现访问的数据不在 Redis 里,就加个互斥锁,保证同一时间内只有一个请求来构建缓存。这个方案解决的是缓存失效后,大量请求同时回源重建的问题。
没有锁时,1000 个请求同时发现缓存没有,就可能一起查数据库、一起计算、一起写缓存。加锁后,第一个请求拿到锁去构建缓存,其他请求等待、快速失败或短暂返回旧值。数据库只承接少量真实重建请求。
另一个办法是后台更新缓存。文中的说法是让缓存“永久有效”,把更新缓存的工作交给后台线程定时更新。严格说,生产里通常会做逻辑过期:物理 key 不马上删除,业务字段里记录过期时间;读请求发现逻辑过期后触发后台刷新,前台仍可先返回旧数据。这样能减少大量请求同时穿过缓存层。
Redis 故障型雪崩要靠限流和高可用
大量 key 同时过期是一种雪崩,Redis 故障宕机是另一种。资料 对 Redis 故障引发的雪崩给了两个方向:服务熔断或请求限流机制,以及构建 Redis 缓存高可靠集群。
服务熔断是暂停业务应用对缓存服务的访问,直接返回错误或降级结果。请求限流是只放少部分请求到数据库处理,多出来的请求在入口直接拒绝或排队。它们听起来不够温柔,但在故障时很必要:保护数据库活着,比让所有请求一起冲进去更重要。
高可靠 Redis 集群则是从缓存层自身减少单点故障。已有内容提到可以通过主从节点构建 Redis 缓存高可靠集群,主节点故障宕机时,从节点可以切换成主节点,继续提供缓存服务。前面讲过主从、哨兵、Cluster,这些能力在这里就派上用场。
缓存击穿:一个热点 key 过期
缓存击穿比雪崩范围小,但压强很集中。相关的定义是:当某个“热点数据”过期时,大量并发请求查询这个缓存不存在的数据,请求直接访问数据库,增加数据库负载。
比如首页有一个热门商品详情,每秒几千个请求都在读。平时它命中 Redis,数据库很轻松。某一刻这个 key 过期了,而缓存还没来得及重建,几千个请求同时发现未命中,就会一起打到数据库。问题只发生在一个 key 上,但因为这个 key 太热,压力仍然可能把数据库打满。
资料 也说缓存击穿是缓存雪崩的一个子集。这个说法可以这样理解:击穿也是缓存失效导致请求落库,只不过失效范围通常集中在单个热点 key,而雪崩更像大面积缓存同时失效或缓存层整体故障。
击穿重点保护重建过程
缓存击穿的常见处理办法,资料 直接指向前面方案:添加互斥锁或者后台更新缓存。这里的重点不是把所有请求都挡住,而是避免大量请求同时去重建同一个热点缓存。
互斥锁做法很直观。缓存未命中后,只有拿到锁的请求可以查询数据库并重建缓存;其他请求等待一小段时间、重试缓存,或者返回降级结果。这样数据库不会被同一个热点 key 的并发重建打穿。
后台更新适合极热数据。你可以让热点 key 不物理过期,或者使用逻辑过期时间。前台请求发现数据逻辑过期后,不一定同步等数据库查询完成,而是触发后台刷新。它牺牲一点实时性,换来高峰期更稳定的读路径。
缓存穿透:数据库里也没有
缓存穿透和前两个问题不同。雪崩和击穿里的数据通常在数据库里存在,只是缓存失效了。穿透访问的数据既不在缓存中,也不在数据库中。文中说,因为无法构建缓存数据,后续所有请求都会向数据库查找,增加数据库负载。
穿透常见原因有两个。一个是业务误操作,缓存中的数据和数据库中的数据都被误删除了。另一个是恶意攻击,通过构造不存在的 key 大量访问缓存,导致数据库被频繁查询。
例如有人不断请求不存在的用户 ID、商品 ID,Redis 查不到,应用回源数据库,数据库也查不到。如果系统什么都不做,这类请求每次都会绕过缓存,持续消耗数据库资源。缓存层失去了拦截价值。
穿透的处理:限制、空值、布隆过滤器
资料 给了三种缓存穿透解决办法。第一,对非法请求做限制。比如在入口层校验 ID 格式、参数范围、用户权限、请求频率。明显不合法的请求,不要让它走到 Redis 和数据库后面。
第二,针对查询的数据,在缓存中设置一个空值或默认值。如果数据库查不到某个 key,可以把“空结果”也写入 Redis,并设置较短 TTL。下次同样请求再来,Redis 直接返回空结果,不必每次都查数据库。
第三,使用布隆过滤器快速判断数据是否存在,避免通过查询数据库来判断。布隆过滤器可以放在缓存访问前面,先判断某个 ID 是否可能存在。如果判断一定不存在,就直接拦截;如果可能存在,再继续查 Redis 和数据库。它适合应对大量不存在 key 的恶意或异常请求。
三个问题的判断口诀
排查时可以先问三个问题。第一,是不是大量 key 在同一时间失效,或者 Redis 整体不可用?如果是,优先按缓存雪崩处理。第二,是不是某一个热点 key 过期,导致大量并发请求都查数据库?如果是,优先按缓存击穿处理。
第三,请求的数据是不是缓存里没有、数据库里也没有,并且无法构建缓存?如果是,重点看缓存穿透。这个时候继续调大 Redis 容量、延长过期时间,不一定有用,因为问题不是缓存过期,而是请求目标本身不存在。
这三个问题都表现为数据库压力变大,但根因不同。雪崩看“范围”,击穿看“热点”,穿透看“数据是否存在”。先判断根因,再选方案,才不会把布隆过滤器拿去解决热点 key 过期,也不会用互斥锁去挡大量非法 ID。
实战里别只做一个措施
缓存异常通常不是单点措施能完全解决的。雪崩要从过期时间、缓存高可用、限流熔断一起考虑;击穿要识别热点 key,并保护缓存重建;穿透要做参数校验、空值缓存和布隆过滤器。
还要配合监控。缓存命中率突然下降、数据库 QPS 突然升高、Redis 连接异常、热点 key 频繁过期、空值缓存比例异常,这些都能提前暴露问题。没有监控,只有事故发生后才知道“数据库怎么突然顶不住了”。
缓存层的目标不是让数据库永远不被访问,而是让数据库只承接该承接的请求。雪崩、击穿、穿透的本质,都是不该落库的请求突然落库。设计方案时,始终盯着这条路径,就不容易跑偏。
面试可以这样回答
如果被问缓存雪崩、击穿、穿透的区别,可以先说:雪崩是大量缓存同一时间失效,或者 Redis 故障,导致大量请求落到数据库;击穿是某个热点 key 过期,大量并发请求访问这个 key 时直接打到数据库;穿透是请求的数据缓存没有、数据库也没有,缓存无法建立,后续请求反复查数据库。
然后分别说处理办法。雪崩可以用随机过期时间、互斥锁、后台更新、服务熔断、请求限流和 Redis 高可用集群。击穿可以对热点 key 加互斥锁,或者使用后台刷新、逻辑过期。穿透可以做非法请求限制、缓存空值或默认值、使用布隆过滤器判断数据是否可能存在。
最后补一句实践判断:雪崩看失效范围,击穿看热点 key,穿透看数据库里是否真的有数据。三者都会导致数据库压力上升,但治理入口不一样。
常见问题
缓存雪崩和缓存击穿最大区别是什么?
缓存雪崩通常是大量 key 同时失效或 Redis 故障,影响范围大;缓存击穿通常是单个热点 key 过期,压力集中在一个热点数据上。
缓存穿透为什么缓存拦不住?
因为请求的数据既不在缓存中,也不在数据库中,系统无法构建正常缓存。相同无效请求后续还会继续查数据库。
为什么缓存雪崩要给过期时间加随机数?
随机过期时间可以避免大量 key 在同一时刻集中失效,把回源请求摊开,降低数据库瞬时压力。
布隆过滤器主要解决哪类问题?
主要用于缓存穿透。它可以在查询 Redis 和数据库之前快速判断数据是否可能存在,对一定不存在的 key 直接拦截。