
Transformer 注意力权重到底表示什么:如何读懂一张注意力图
围绕不同注意力头关注不同位置的例子,解释注意力热力图的行列含义、权重分布、头与层的差异,以及可视化结果的阅读边界。
相关工具
文章目录(8 个章节)
注意力图先回答了什么问题
注意力热力图通常把一个注意力头在一条序列上的权重画成矩阵。颜色越深,表示对应位置的 Softmax 权重越大;颜色越浅,表示当前 Query 对那个 Key 位置分配的权重越小。它最直接回答的是:在计算某个位置时,模型把注意力分配到了哪些位置。
资料 用“it”的例子说明,不同注意力头可能关注不同位置。一个头关注“The animal”,另一个头关注“tired”,于是“it”的表示同时融入了指代对象和状态信息。热力图把这种位置关系画出来,帮助我们看到模型内部的一部分计算结果。
但注意力图不是模型完整思考过程,也不是天然的因果证明。它展示的是某一层、某一个头、某一条输入下的权重分布,解读时必须把范围和条件说清楚。
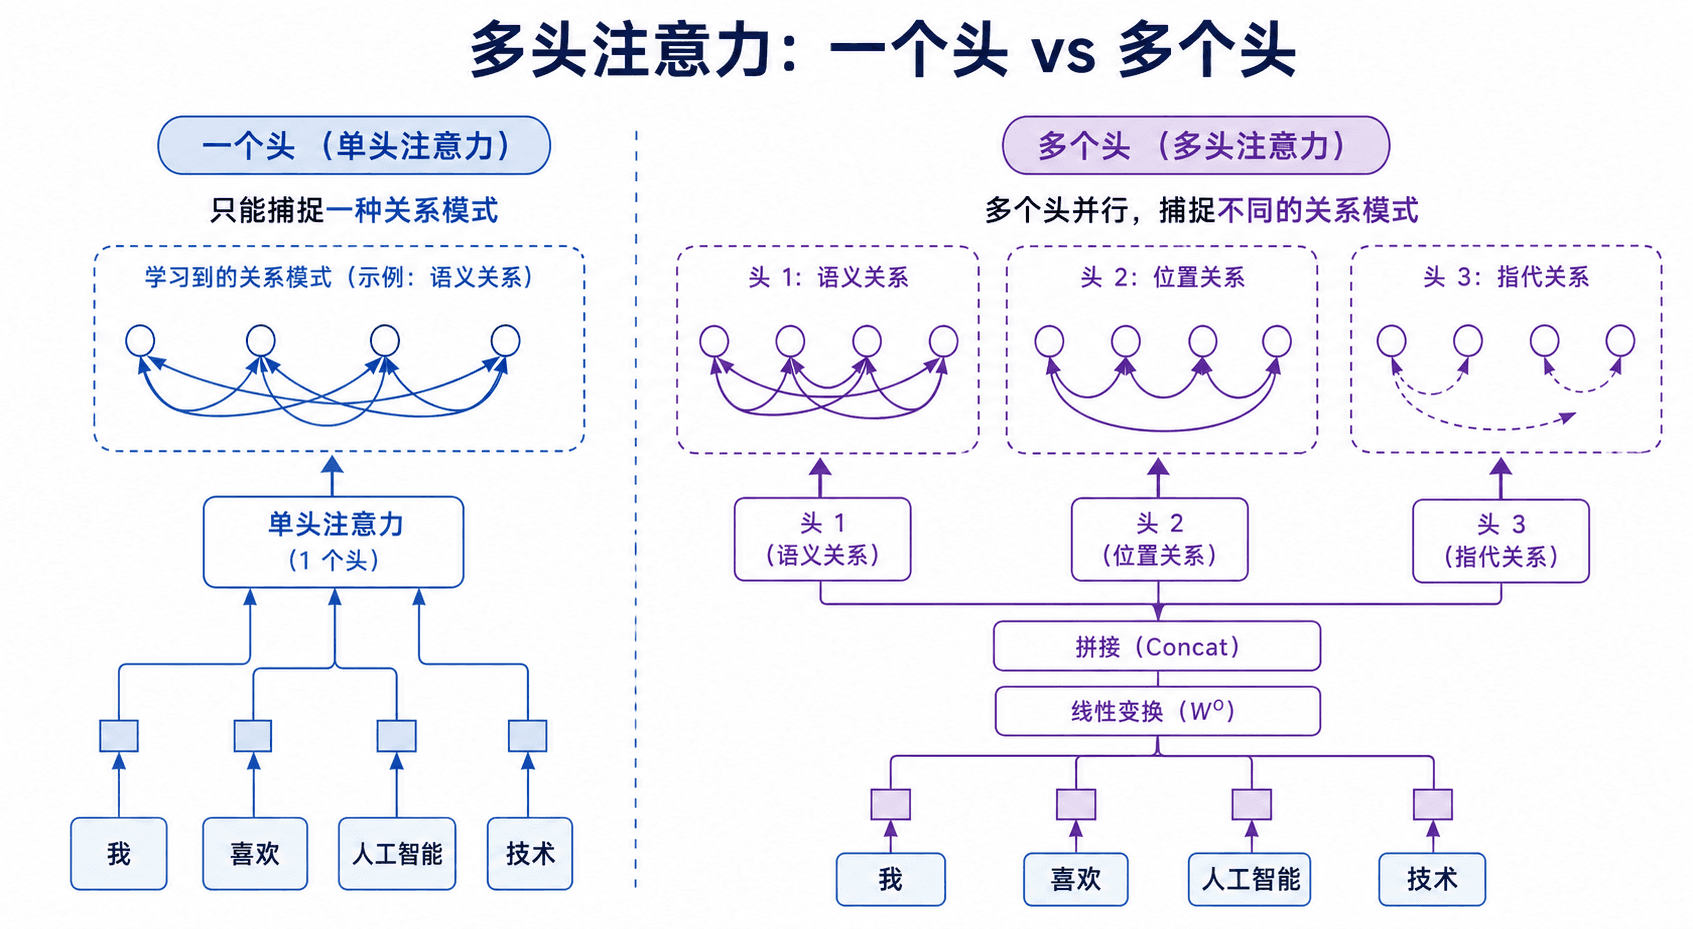
行是 Query 位置,列是 Key 位置,每一行经过 Softmax 归一化,颜色越深表示注意力权重越大。
先分清行和列
读取热力图时,第一步不是寻找最深的颜色,而是确认坐标轴。行通常代表 Query,也就是正在生成或更新表示的位置;列代表 Key,也就是可能被当前 Query 关注的位置。第 i 行描述的是第 i 个位置如何查看整句。
如果查看“it”所在的行,横向扫过这一行,就能看到它对“The animal”“tired”以及其他 token 分别分配了多少权重。反过来看某一列,表示所有 Query 位置对这个 Key 的关注情况,这与单独解释某个位置的行为不是一回事。
不同实现可能转置矩阵、调整坐标方向或只展示部分区域,所以图例和代码定义要一起确认。看到颜色深浅后直接下结论,是最常见的误读来源。
为什么每一行的权重会加起来等于一
注意力分数经过缩放、掩码和 Softmax 后,通常沿 Key 位置归一化。因此,对于一个有效的 Query 位置,它对所有允许关注位置的权重之和接近 1。热力图上的每一行不是独立的任意分数,而是一组概率式的相对分配。
如果存在 Padding Mask,被屏蔽的位置权重应接近 0;如果是解码器的因果自注意力,未来位置也应被遮挡。于是热力图中的空白区域可能是模型不关注,也可能是规则上不允许关注,需要结合掩码判断。
Softmax 归一化还意味着颜色需要相对阅读。同一行里最深的格子表示该行中相对更受关注,不代表它在所有句子、所有头和所有层里都是全局最重要的位置。
一个热力图如何描述 it
以“The animal was tired. It lay down.”为例,如果“it”所在行在“animal”列颜色较深,可以说这个头在这条样本中对指代对象分配了较高权重。若另一个头在“tired”列更深,则可以说它同时保留了与状态相关的上下文。
这种描述比“模型理解了 it 指代 animal”更谨慎。权重说明了信息交互的强弱,但“指代关系是否真正被用于最终输出”还要看后续层、输出变化和其他路径。
更可靠的分析方式是做对照:遮挡“animal”或替换“tired”,再观察相关头的权重和模型输出是否发生稳定变化。单看一张图,不能取代这种验证。
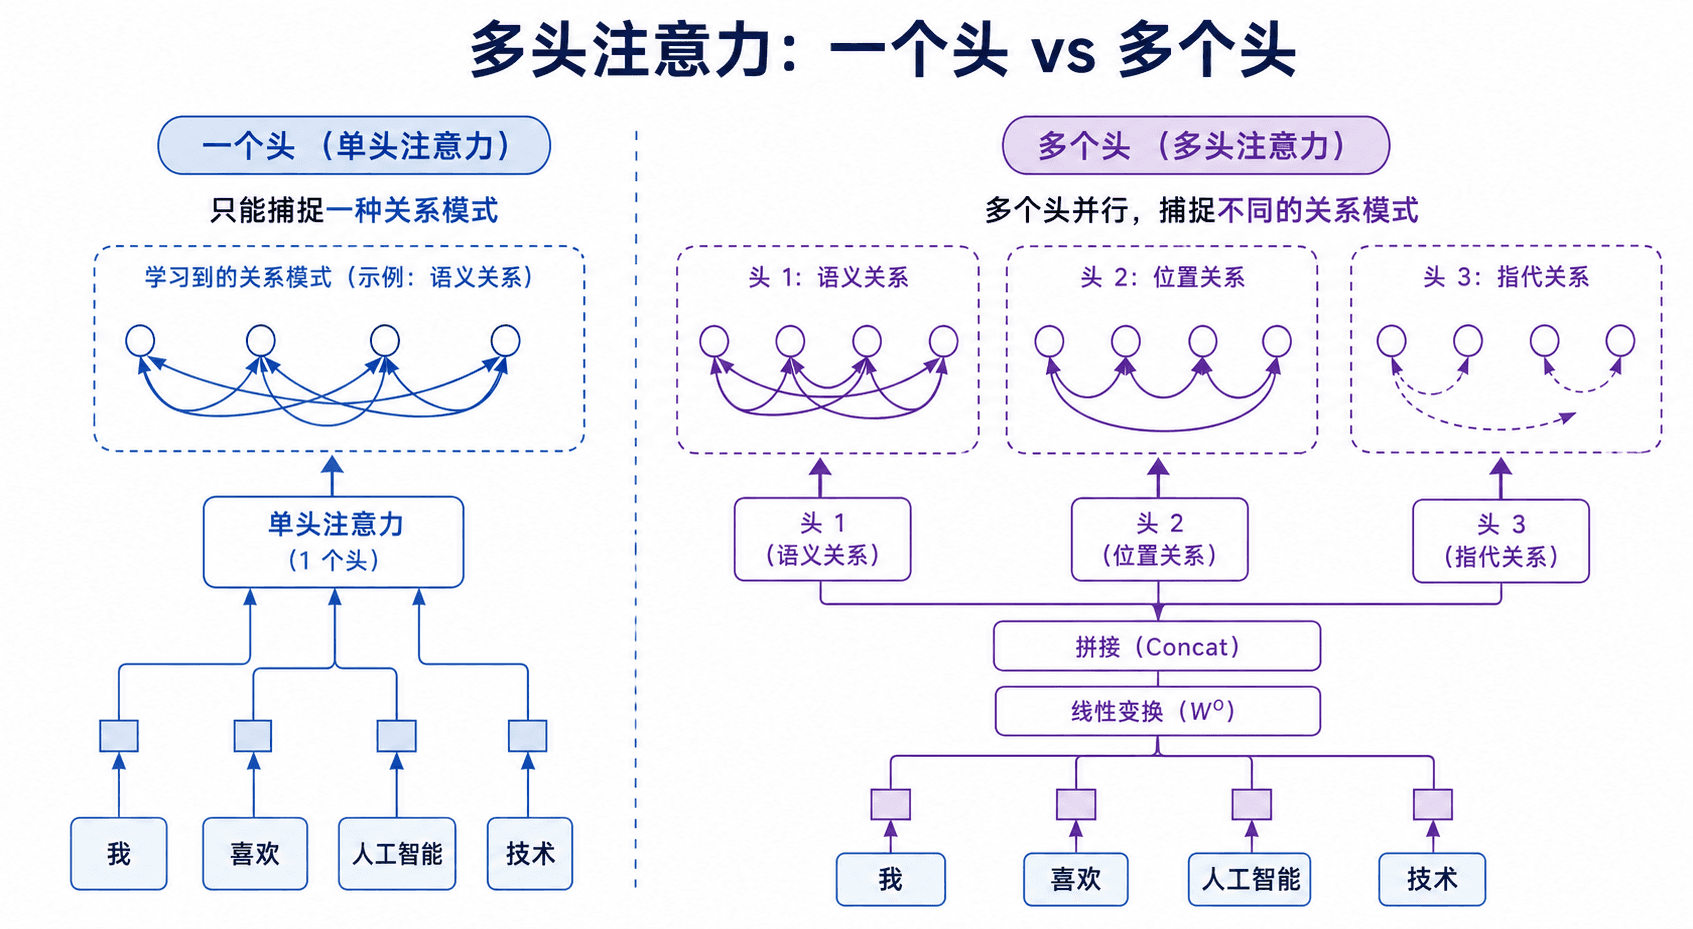
同一句话中,不同头可以分别关注指代对象、状态信息或局部句法关系。
浅层和深层的注意力图不能简单贴标签
浅层可能更接近输入嵌入和局部上下文,某些头会表现出相邻位置、标点或简单顺序关系。随着层数增加,表示经过多次交互,注意力可能呈现更远距离的关联或更复杂的分布。
但这不是固定规律。不同模型和任务的层分工可能不同,有的长距离关系在较早层就出现,有的关系需要多层传播才能形成。热力图可以帮助观察趋势,却不能仅凭层数给每层贴上“词法层”或“语义层”的标签。
跨层比较时,还要确认比较的是同一种注意力。编码器自注意力、解码器掩码自注意力和交叉注意力的行列含义不同,不能把它们的图直接混在一起解释。
注意力高就一定重要吗
注意力权重高,表示当前 Query 在这个注意力子层中分配了较多权重。它是信息聚合过程中的一个信号,但不是最终输出贡献的唯一衡量。Value 的内容、输出投影、残差路径、后续层和其他头都会影响最终结果。
某个位置权重不高,也不意味着它完全没有作用。多个位置的较小权重可能共同提供背景信息;一个位置的高权重如果携带的 Value 内容不适合当前任务,也不一定会显著改善输出。
因此,注意力图更适合作为观察和提出假设的工具。之后还需要通过遮挡、替换、梯度归因或输出对比来验证假设,不能把热力图直接当成唯一解释。
先确认行列坐标,再比较头与层,最后结合输出行为验证;注意力高不等于唯一原因。
怎样做一次可靠的注意力图分析
第一步固定输入和任务,记录模型层、注意力头、Mask 状态以及色标范围。第二步确认矩阵方向,写清楚行是 Query 还是 Key,列是 Key 还是 Query。第三步选择具体位置,例如 it 所在行,观察它的高权重位置。
第四步做横向比较,查看同一层不同头是否关注不同位置;再做纵向比较,查看同一头在不同层是否出现稳定变化。第五步做输出验证,遮挡或替换被关注 token,观察模型表示或最终预测是否发生对应改变。
最后保留原始数值,不只保存截图。图像适合交流,原始权重适合复核。只有当坐标、数值、模型状态和验证结果都能对上时,注意力图才真正具备分析价值。
把注意力图放回 Transformer 主线
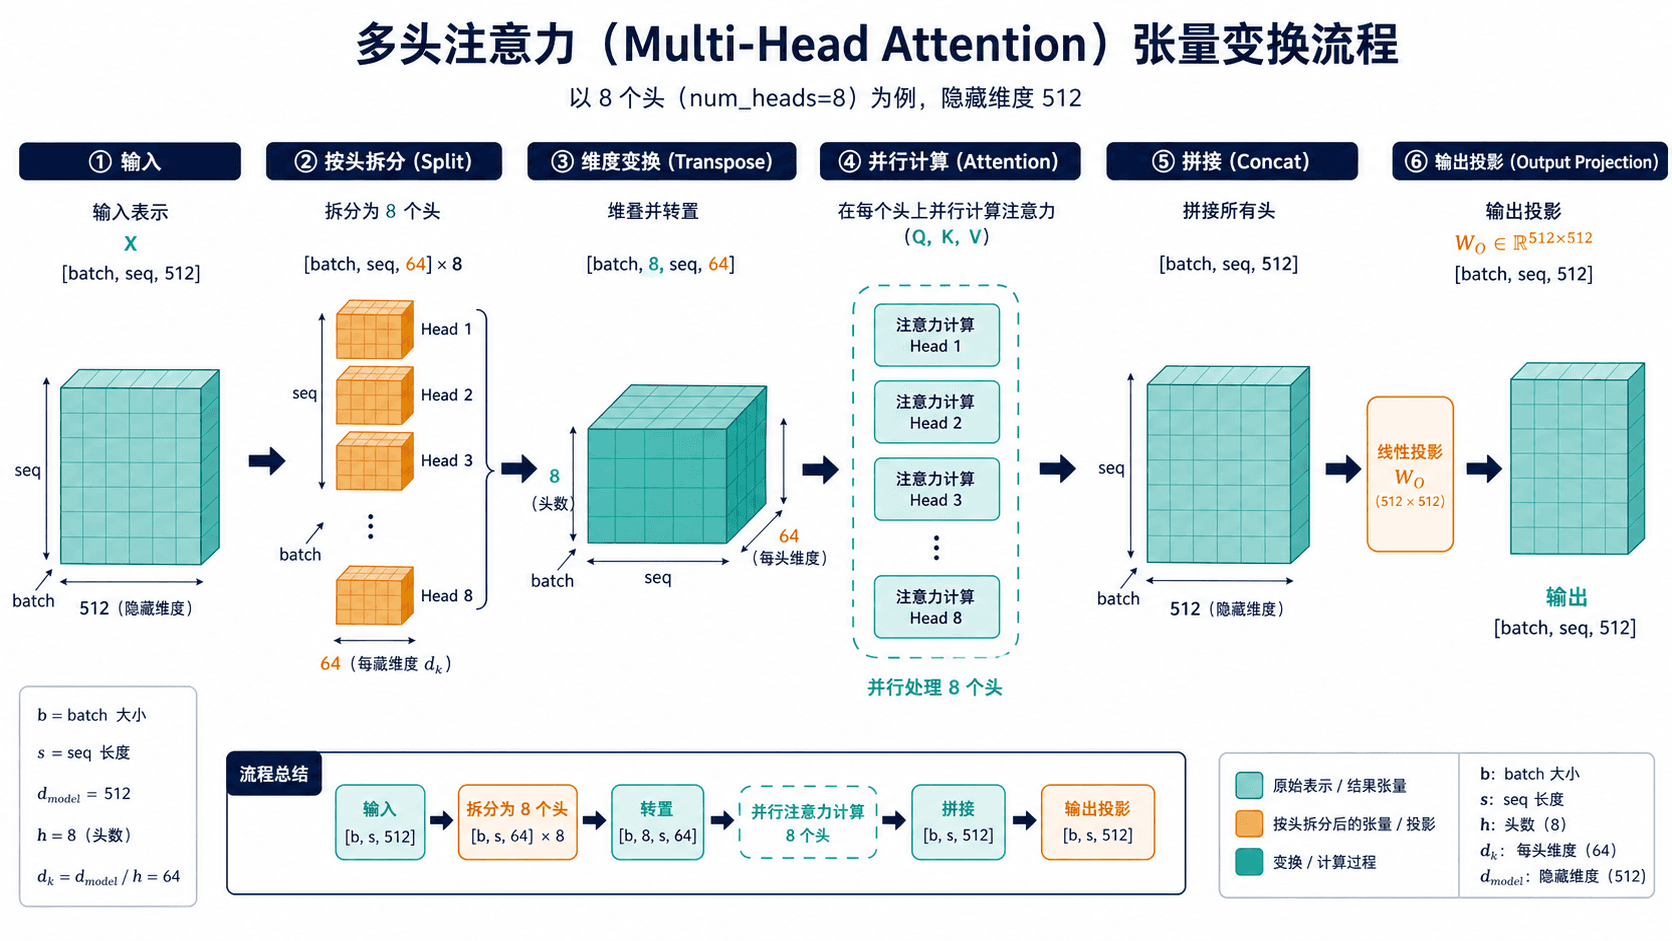
注意力图来自 QK^T 分数经过缩放、掩码和 Softmax 后的权重矩阵。它展示的是每个 Query 位置如何把信息读取范围分配给 Key 位置。多头机制让这种分配在不同子空间中同时发生,最后再把各头输出拼接。
文中 it 分别关注 animal 和 tired 的例子,说明注意力可以从不同角度组织上下文。读图时要把它放回具体的头、层和输入,不能把一张局部权重图扩大成对整个模型的单一解释。
最稳妥的使用方式是:用热力图发现关系,用对照实验验证关系,再结合最终输出判断关系是否真的影响了任务结果。这样既能利用可视化的直观性,也能保留对模型复杂性的尊重。
常见问题
注意力热力图的行和列分别是什么?
通常行表示 Query 位置,列表示 Key 位置。查看某一行,可以看到当前 Query 对各个 Key 位置分配的注意力权重,但具体方向仍需以实现和图例为准。
颜色最深的位置就是模型最重要的词吗?
只能说它在当前头、当前层和当前输入下获得了较高注意力权重,不能据此断言它是最终输出的唯一或绝对原因。
为什么不同注意力头的图不一样?
不同头使用独立的 Q/K/V 投影,会在不同子空间中计算位置关系,因此可能关注不同的指代、状态或局部结构。