
Transformer 为什么使用 Dropout 与 Label Smoothing:防止模型过度自信
训练设置中理解 Dropout 如何减少过拟合,Label Smoothing 如何把硬目标变成平滑分布,并看清它们与交叉熵、验证集和生成效果的关系。
相关工具
文章目录(12 个章节)
训练准确不等于泛化得好
Transformer 的参数量通常很大,注意力和前馈网络可以表达复杂的模式。如果模型只是在训练样本上越来越自信,却没有学到可迁移的规律,就会出现训练损失继续下降、验证效果却停滞甚至变差的情况。
Dropout 和 Label Smoothing 都属于训练阶段常见的正则化思路。前者随机减少部分中间信息的依赖,后者调整目标分布,避免模型把全部概率质量都压在唯一正确标签上。
它们解决的问题有相似之处,但作用位置不同。Dropout 作用于表示或权重计算过程,Label Smoothing 作用于监督信号。一个改变模型看到的信息,一个改变模型被要求达到的目标。
Dropout 是怎样工作的
训练时,Dropout 会按照设定概率随机把部分神经元或数值置为 0,并对保留下来的部分进行缩放,使整体期望保持相对稳定。每个批次、每次前向计算使用的随机丢弃位置都可能不同。
这样做会阻止模型过度依赖某几个固定通道。一个特征这次被丢弃,网络就需要学会利用其他信息完成任务;多次训练后,表示通常会更有冗余,也更不容易因为某个局部特征失效而完全崩溃。
Dropout 不是永久删除参数,也不是把模型变小。它只在训练前向过程中临时屏蔽部分值,推理时通常关闭 Dropout,使用完整表示。
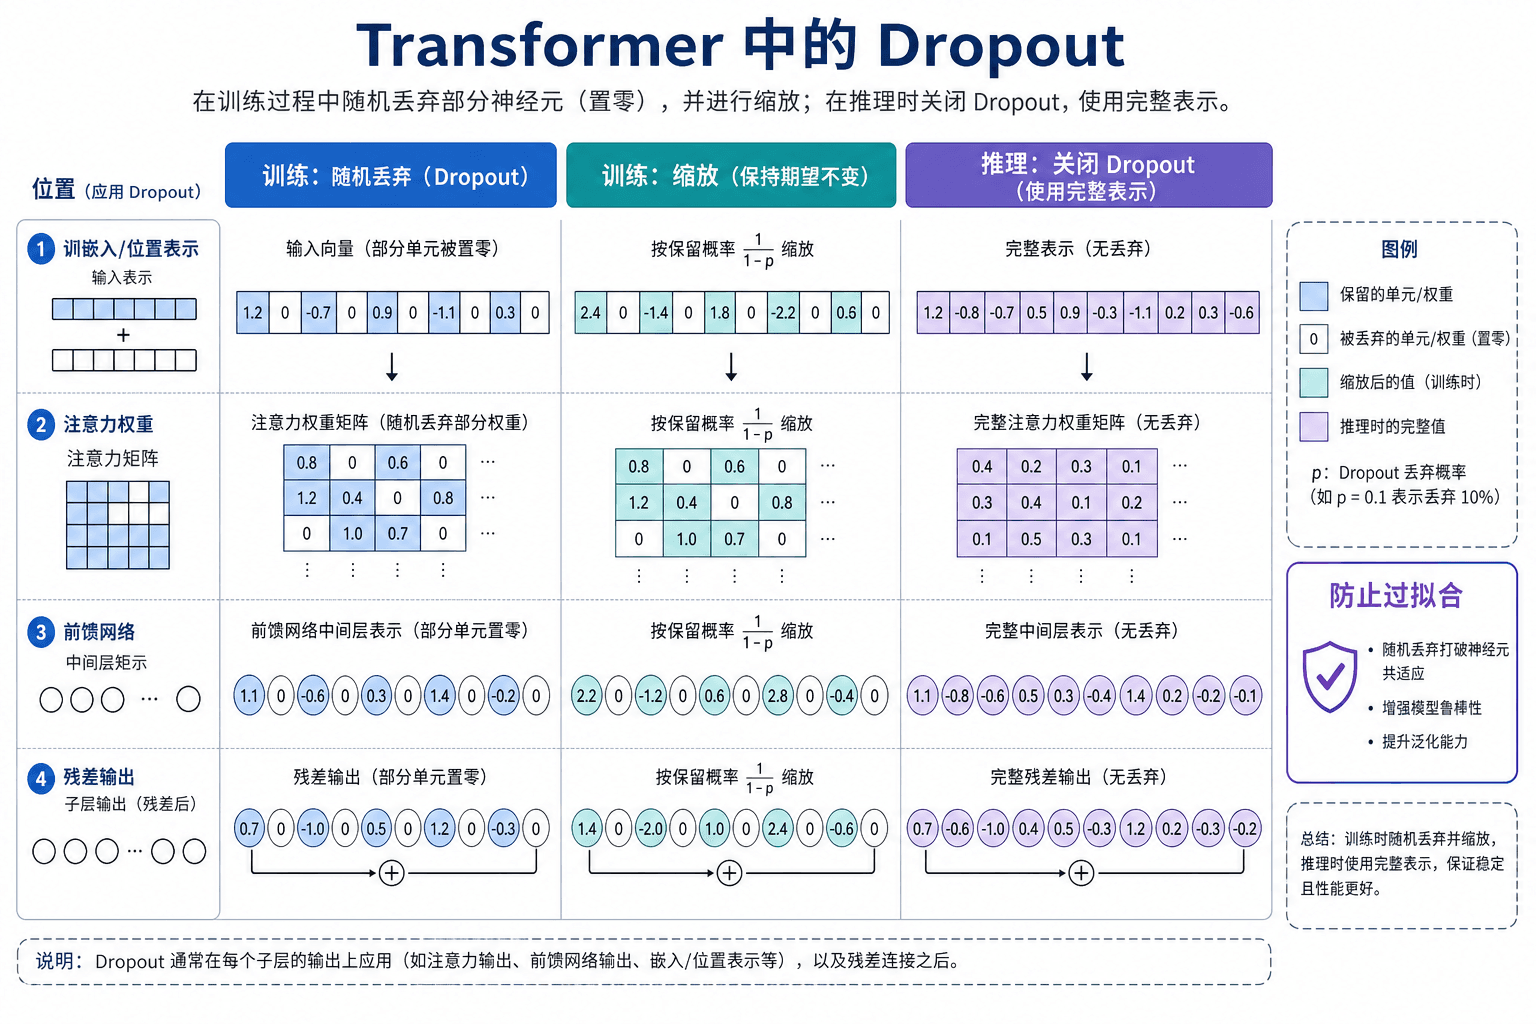
训练时随机丢弃部分表示并按比例缩放,推理时关闭 Dropout,使用完整的注意力、前馈和残差表示。
Transformer 中 Dropout 可能出现在哪里
经典 Transformer 结构中,Dropout 可以用于词嵌入与位置表示相加后的输入,也可以用于注意力权重、前馈网络输出和子层输出。具体放置位置会随模型实现变化,不能只凭“用了 Dropout”判断所有地方都相同。
注意力权重上的 Dropout 会随机削弱部分关注关系;前馈网络中的 Dropout 会随机削弱中间特征;残差路径附近的 Dropout 则会影响子层向主干添加信息的方式。它们都在降低模型对固定计算路径的依赖。
Dropout 概率过大,可能让有效信息损失过多,训练变慢或欠拟合;概率过小,又可能无法明显缓解过拟合。选择时要结合数据量、模型规模和验证集表现,而不是默认越大越好。
训练和推理的 Dropout 状态必须不同
训练模式下,Dropout 会随机丢弃并缩放;推理模式下,Dropout 应关闭,模型使用完整表示。如果推理时仍然开启 Dropout,同一个输入多次运行可能得到不同结果,概率分布和生成文本也会额外波动。
反过来,如果训练时没有正确开启 Dropout,配置中虽然写了丢弃概率,实际模型仍可能以完整路径训练,正则化效果自然不会出现。检查训练框架的模式切换,比只看配置字段更可靠。
对于需要多次随机前向来估计不确定性的特殊方法,推理阶段可能故意保留 Dropout,但那是有明确目的的额外设计,不是常规生成流程的默认状态。
硬标签为什么可能让模型过度自信
普通分类或下一词交叉熵通常使用 one-hot 目标:正确词的目标概率是 1,其他词的目标概率是 0。这样的监督会持续推动模型把更多概率压到正确答案上,训练集上可能得到非常高的置信度。
如果数据存在噪声、多个答案都合理,或者训练样本并不能完全代表真实分布,过于尖锐的目标会让模型把不确定的判断也当成绝对事实。模型可能在训练集上表现很好,但面对稍有变化的输入就不够稳健。
Label Smoothing 的想法是保留正确词的主要概率,同时给其他词分配少量概率质量,让目标分布不再是一个完全尖锐的独热向量。
Label Smoothing 如何改变目标分布
设词表大小为 V,正确词对应的目标类别为 c,平滑系数为 ε。硬目标是 q_c=1、其他 q_i=0;平滑目标可以写成 q_c=1-ε,其他类别分配 ε/(V-1),具体分配方式也可能因实现略有不同。
训练时,模型预测分布 p 会和这个平滑后的目标 q 计算交叉熵,而不是只和 one-hot 目标计算。正确词仍然是主要目标,但模型不再被要求把其他所有词的概率都压到严格的 0。
这样可以缓解过度自信,让输出概率更有校准性。它不等于告诉模型“其他词也同样正确”,而是让监督信号保留一点不确定性。
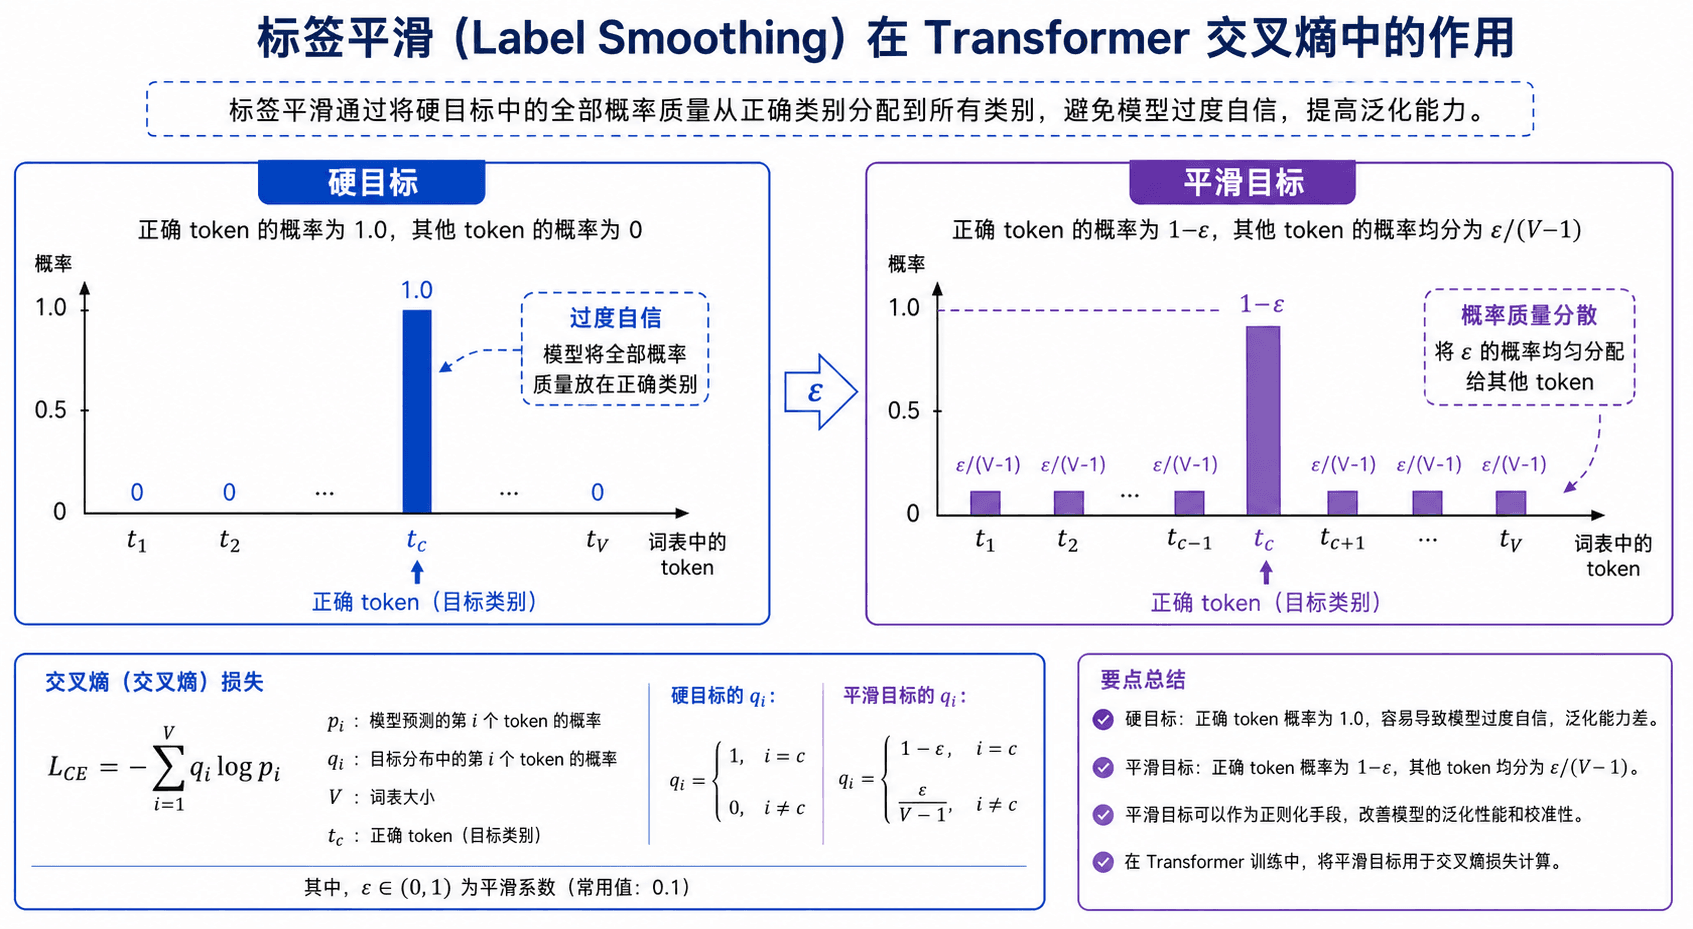
硬目标把全部概率质量放在正确词上,平滑目标保留正确词的主要概率,同时给其他词分配少量质量。
Label Smoothing 会怎样影响交叉熵
使用硬目标时,损失主要是 -log p_c,模型只要不断提高正确词的概率,损失就会持续降低。使用平滑目标后,损失会同时考虑其他词的预测概率,模型需要形成更合理的整体分布。
这通常会降低模型对训练目标的极端自信,但不意味着训练损失一定更低。平滑目标改变了任务本身的监督定义,不能直接把使用不同目标得到的损失数值简单比较。
评估时要结合验证损失、准确率、生成质量和概率校准情况。对某些任务,Label Smoothing 可能带来更好的泛化;对要求精确概率或标签非常确定的任务,也需要谨慎观察。
Dropout 与 Label Smoothing 的区别
Dropout 改变的是模型内部的前向路径。一次训练中,部分表示被临时屏蔽,模型需要在不同子网络状态下完成预测。Label Smoothing 改变的是目标分布,模型不再被要求对正确词和错误词给出极端的 1 与 0。
两者可以一起使用,但它们并不是越多越好。Dropout 过强可能导致欠拟合,Label Smoothing 过强可能让模型对正确目标不够集中。需要根据训练和验证曲线判断是否正则化过度。
可以把它们理解为两种不同的提醒:Dropout 提醒模型不要依赖单一路径,Label Smoothing 提醒模型不要把有限样本中的判断当成绝对确定。
它们与残差和层归一化怎样配合
残差连接和层归一化主要服务于深层信息和梯度的稳定传播,Dropout 主要降低过拟合,Label Smoothing 主要调整监督信号。四者可以出现在同一训练流程中,但解决的不是同一个问题。
Dropout 的位置会影响残差分支中的信息量。放在子层输出附近时,模型学习的是对原表示添加的随机变化;放在注意力权重上时,模型学习的是在部分关系被削弱时仍然完成上下文交互。具体顺序要以模型定义为准。
LayerNorm 可以稳定数值尺度,却不能自动防止模型记住训练样本;Dropout 可以增加路径扰动,却不能修复错误标签。把不同组件的职责分清,调参时才不容易互相替代。
如何判断正则化是否合适
如果训练损失下降很快、验证损失明显更高,可能需要增加正则化或检查数据分布;如果训练和验证损失都下降缓慢,甚至训练集也学不好,可能是 Dropout 太强、Label Smoothing 太大、学习率不合适或模型容量不足。
观察生成任务时,还要检查输出是否变得过于保守、重复或缺少细节。Label Smoothing 可能改善泛化,但如果目标过度平滑,模型对正确词的区分能力也可能受到影响。
建议一次只调整一个主要因素,并固定验证样本和解码策略。否则 Dropout、Label Smoothing、学习率和采样温度同时变化,很难判断生成差异来自训练还是输出选择。
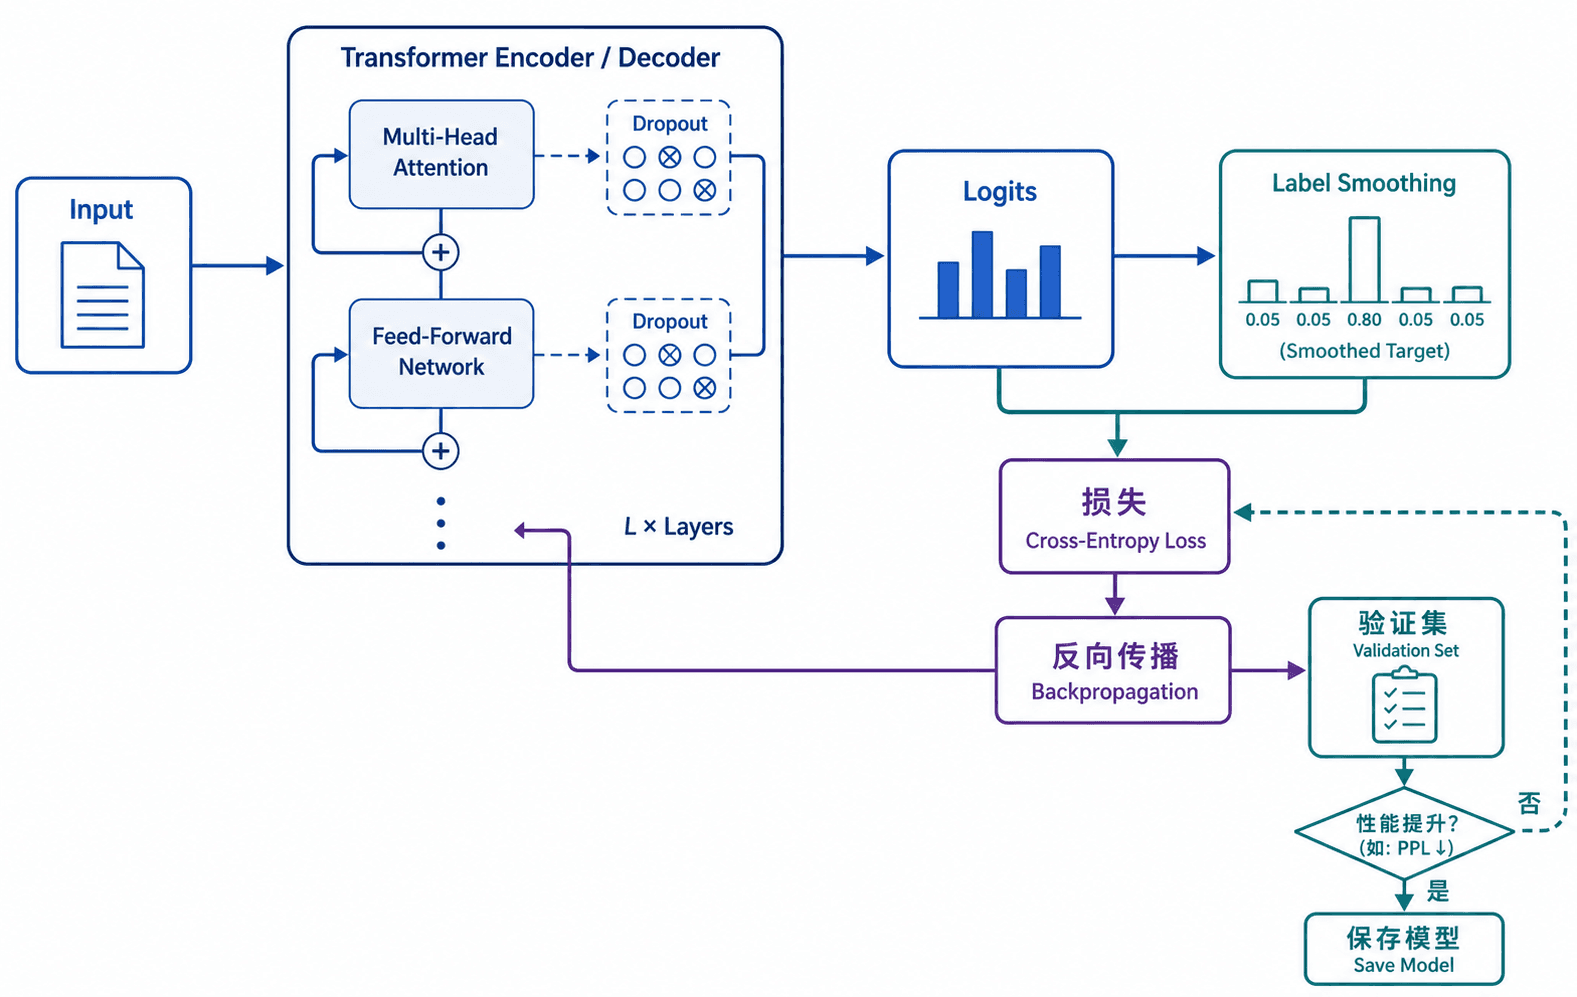
Dropout 作用于模型内部路径,Label Smoothing 作用于监督目标,二者共同进入损失和验证流程。
训练时的四个检查点
第一确认 Dropout 只在训练模式下开启,推理模式下关闭。第二确认 Label Smoothing 只作用于有效目标位置,PAD 等忽略位置不能错误地参与损失。第三观察训练和验证损失的差距,第四观察固定样本的生成稳定性和概率分布。
这四步能区分实现问题和参数问题。若推理结果每次不同,先检查模式切换;若损失异常,先检查目标和忽略位置;若训练很好但验证变差,再考虑正则化强度。
正则化的目标不是让训练曲线更难看,而是让模型在未见样本和稍有变化的输入上仍然保持可靠表现。最终评价要回到任务指标。
训练开启 Dropout,推理关闭 Dropout。
平滑目标只作用于需要计算损失的位置。
同时比较训练损失和验证损失的变化。
观察生成稳定性、概率分布和任务质量。
把正则化放回 Transformer 主线
Transformer 的训练过程可以拆成几层:注意力和前馈网络负责计算表示,残差和层归一化帮助深层传播,Adam 和学习率调度负责更新参数,Dropout 减少对固定路径的依赖,Label Smoothing 调整监督目标的尖锐程度。
这些机制共同影响模型的泛化能力和输出置信度,但都不能替代正确的数据、目标对齐和验证设计。正则化是让模型少走偏路,不是让错误训练变成正确训练。
阅读 Transformer 训练配置时,可以分别寻找 Dropout 概率、Label Smoothing 系数、忽略位置、训练模式和验证指标,再判断这些设置是否与当前任务相匹配。
常见问题
Dropout 在推理阶段还会开启吗?
常规推理通常关闭 Dropout,使用完整表示;只有专门研究不确定性等场景,才可能有意保留随机丢弃。
Label Smoothing 会不会把错误答案也当成正确答案?
它仍然把正确词作为主要目标,只是给其他词分配少量概率质量,避免目标分布过于尖锐。
Dropout 和 Label Smoothing 可以同时使用吗?
可以,它们分别作用于模型内部路径和监督目标,但需要根据验证结果控制强度,避免正则化过度。