
Transformer 为什么使用矩阵计算自注意力:从逐词计算到一次并行处理
围绕矩阵化 Self-Attention,解释逐词计算与矩阵计算的对应关系,以及 Q/K/V、注意力矩阵和并行训练如何连接。
相关工具
文章目录(10 个章节)
逐词计算和矩阵计算在算同一件事
理解自注意力时,通常先从一个词开始:把当前词变成 Query,把所有词变成 Key 和 Value,再计算当前词对所有位置的关注权重。换到第二个词时,重复同样的步骤。这样的描述很直观,却容易让人误以为模型真的要一个词一个词地循环计算。
资料 在“使用矩阵计算 Self-Attention”一节中把这条路径改写成矩阵形式。输入矩阵 X 的每一行代表一个 token 的向量,Q、K、V 矩阵的每一行代表对应位置的 Query、Key 和 Value。所有位置的投影和两两比较,可以通过矩阵乘法一次完成。
两种写法在数学上表达的是同一个注意力机制,区别在于组织计算的方式。逐词写法方便讲清概念,矩阵写法更适合真正的批量计算和硬件并行。
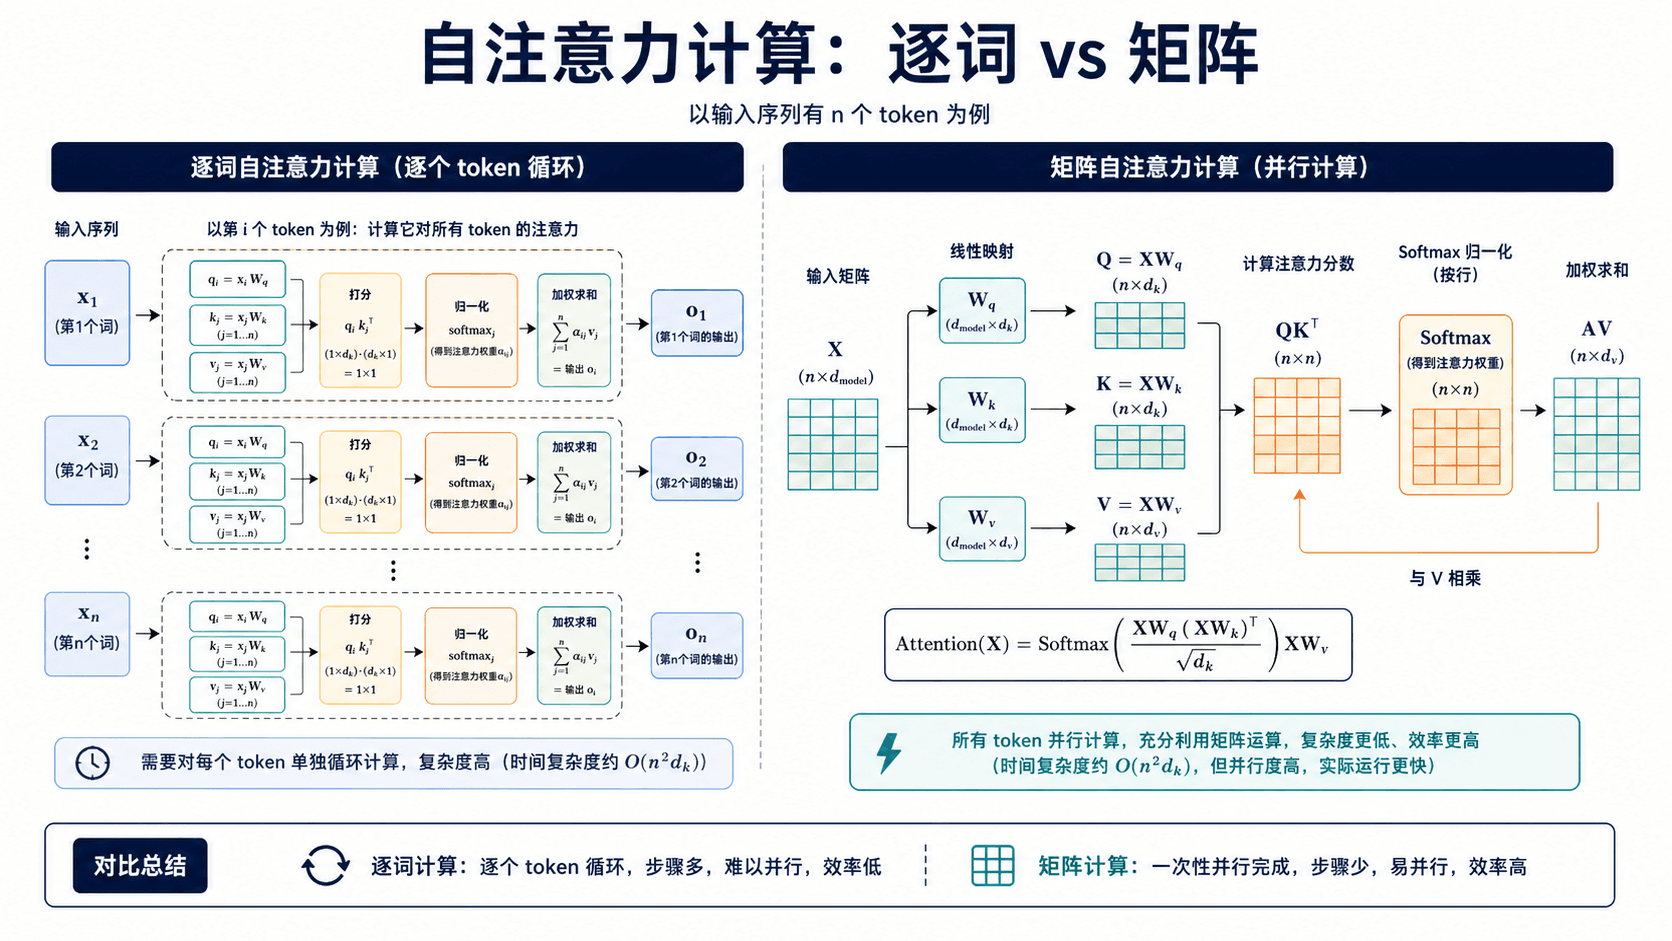
左侧逐个 token 循环,右侧把所有位置组成矩阵后一次完成投影、打分、Softmax 和加权求和。
输入矩阵 X 的每一行代表什么
假设一条序列有 n 个 token,每个 token 的向量维度是 d_model,那么输入矩阵 X 的形状就是 [n, d_model]。第 1 行是第 1 个 token 的表示,第 2 行是第 2 个 token 的表示,行顺序保留了序列位置。
在实际训练中,前面还会多一个 batch 维度,形状通常写成 [batch, n, d_model]。为了理解矩阵公式,可以先忽略 batch,把一条样本看成一个二维矩阵;真正实现时,矩阵乘法会在 batch 维度上同时进行。
矩阵的每一行仍然是一个位置的表示,矩阵化并没有把词序打乱,也没有把所有词压成一个向量。它只是把多个位置放在同一个规则容器中,方便一次调用底层矩阵运算。
Q、K、V 如何通过一次投影得到
逐词写法中,第 i 个输入向量分别与 W_Q、W_K、W_V 相乘,得到 q_i、k_i、v_i。把所有输入向量按行堆起来之后,就可以写成 Q = XW_Q、K = XW_K、V = XW_V。
如果 X 的形状是 [n, d_model],W_Q 的形状是 [d_model, d_k],那么 Q 的形状就是 [n, d_k]。K 通常具有相同的最后一维,V 则是 [n, d_v]。一次矩阵乘法会同时为 n 个位置产生投影结果。
这种写法还带来一个重要好处:所有位置使用同一组投影矩阵,参数共享关系一眼就能看出来。模型不是为句子中的每个位置准备一套独立参数,而是用同一组变换处理不同位置的输入表示。
QK^T 为什么能一次得到所有位置的分数
Q 的每一行是一个 Query,K 的每一行是一个 Key。QK^T 的第 i 行第 j 列,正好是 q_i 与 k_j 的点积,也就是第 i 个位置对第 j 个位置的匹配分数。于是,一个 [n, d_k] 与一个 [d_k, n] 相乘,就得到 [n, n] 的完整分数矩阵。
如果手工计算,需要为每个 Query 和每个 Key 做一次点积,一共 n 的平方个组合。矩阵乘法把这些组合放进统一的运算中,底层库可以使用连续内存、向量化指令和 GPU 的矩阵核心来同时处理。
分数矩阵的行列含义必须分清:行对应 Query 位置,列对应 Key 位置。后续沿列方向做 Softmax,得到每个 Query 对所有 Key 位置的注意力分布。
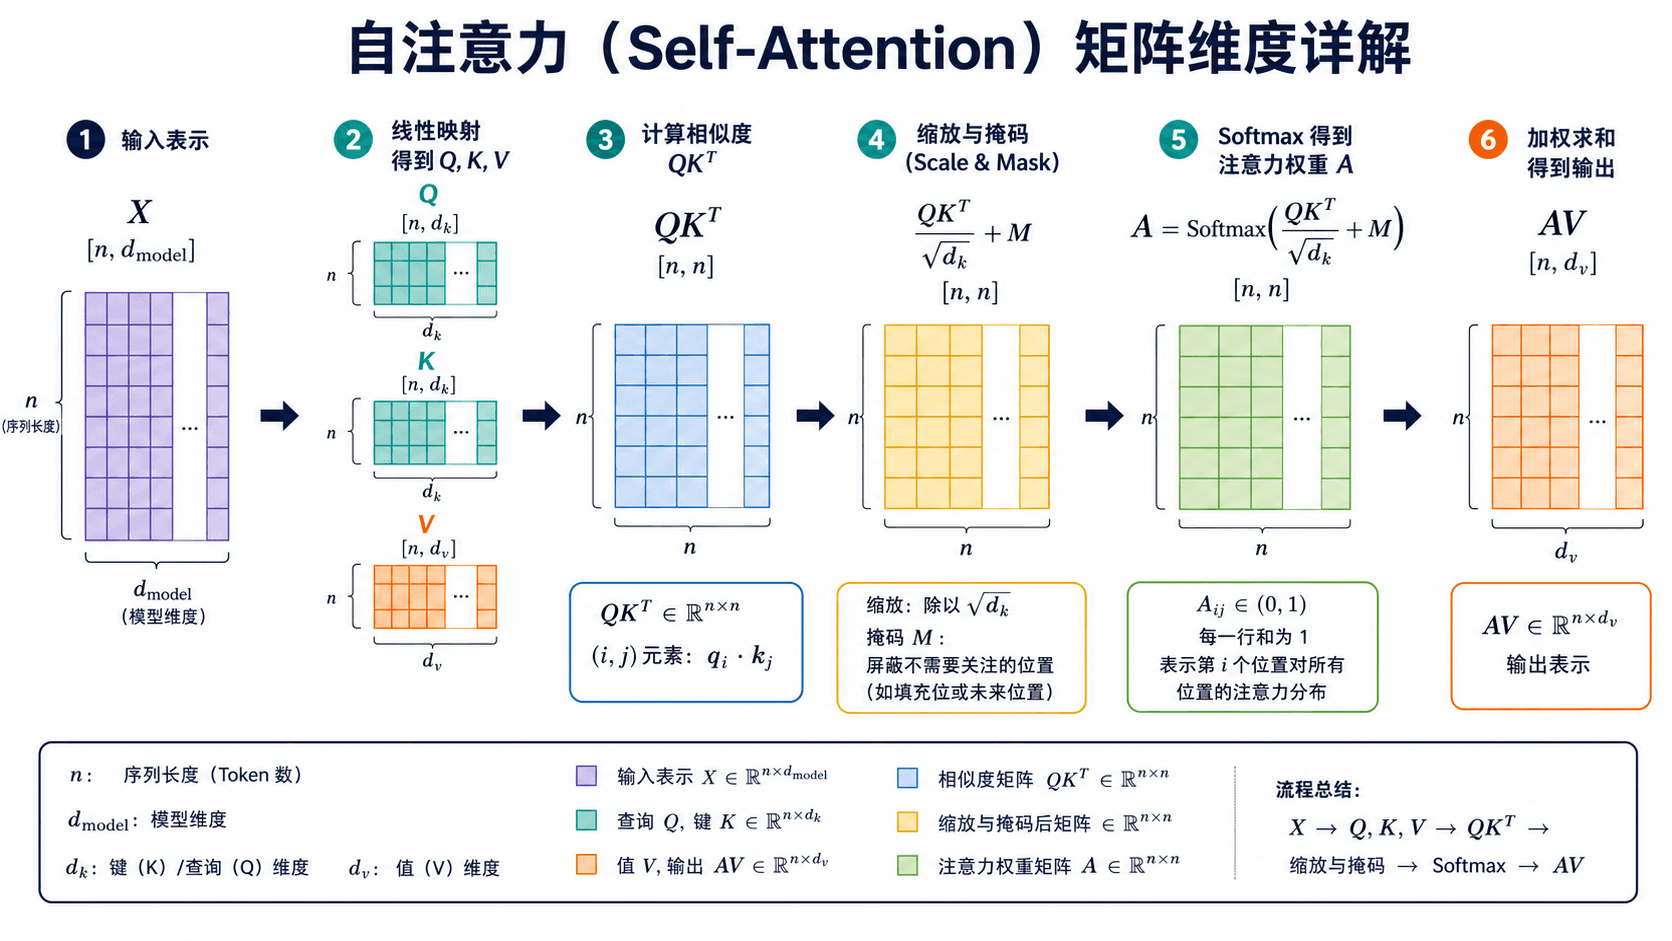
从 X 到 Q/K/V,再到 QK^T、缩放与掩码、Softmax 权重和最终输出的矩阵形状变化。
Softmax 和加权求和也能矩阵化
得到 [n, n] 的分数矩阵后,先除以 sqrt(d_k),再加入 Padding Mask 或 Sequence Mask,最后沿每一行做 Softmax。结果 A 仍然是 [n, n],其中 A 的每一行是一个 Query 对所有位置的注意力权重。
逐词计算时,第 i 个输出写成对所有 v_j 的加权求和。矩阵形式则直接写成 O = AV,其中 A 是 [n, n],V 是 [n, d_v],结果 O 是 [n, d_v]。矩阵乘法的第 i 行,正好等于逐词公式里第 i 个位置的加权求和。
因此,矩阵化并没有省略注意力逻辑,只是把 n 个位置的同类操作放在一起。掩码、缩放和 Softmax 仍然存在,只是以矩阵和逐行运算的形式出现。
为什么矩阵计算特别适合 Transformer
RNN 的核心状态依赖前一时刻结果,序列位置天然形成一条计算链。训练时,即使输入已经全部准备好,后一个位置也要等待前一个位置更新。自注意力则可以在训练阶段同时拿到整段输入,把位置之间的关系交给矩阵运算统一处理。
GPU 和 TPU 擅长执行大规模矩阵乘法。将 token 表示组成矩阵后,硬件可以同时处理多个位置、多个样本和多个注意力头。矩阵化带来的不只是代码更短,而是让模型计算结构与并行硬件更匹配。
需要注意的是,并行计算不等于注意力成本消失。QK^T 仍然会产生 [n, n] 的位置关系矩阵,序列越长,计算和显存开销仍可能按平方增长。矩阵化主要提高了单位时间内的处理效率。
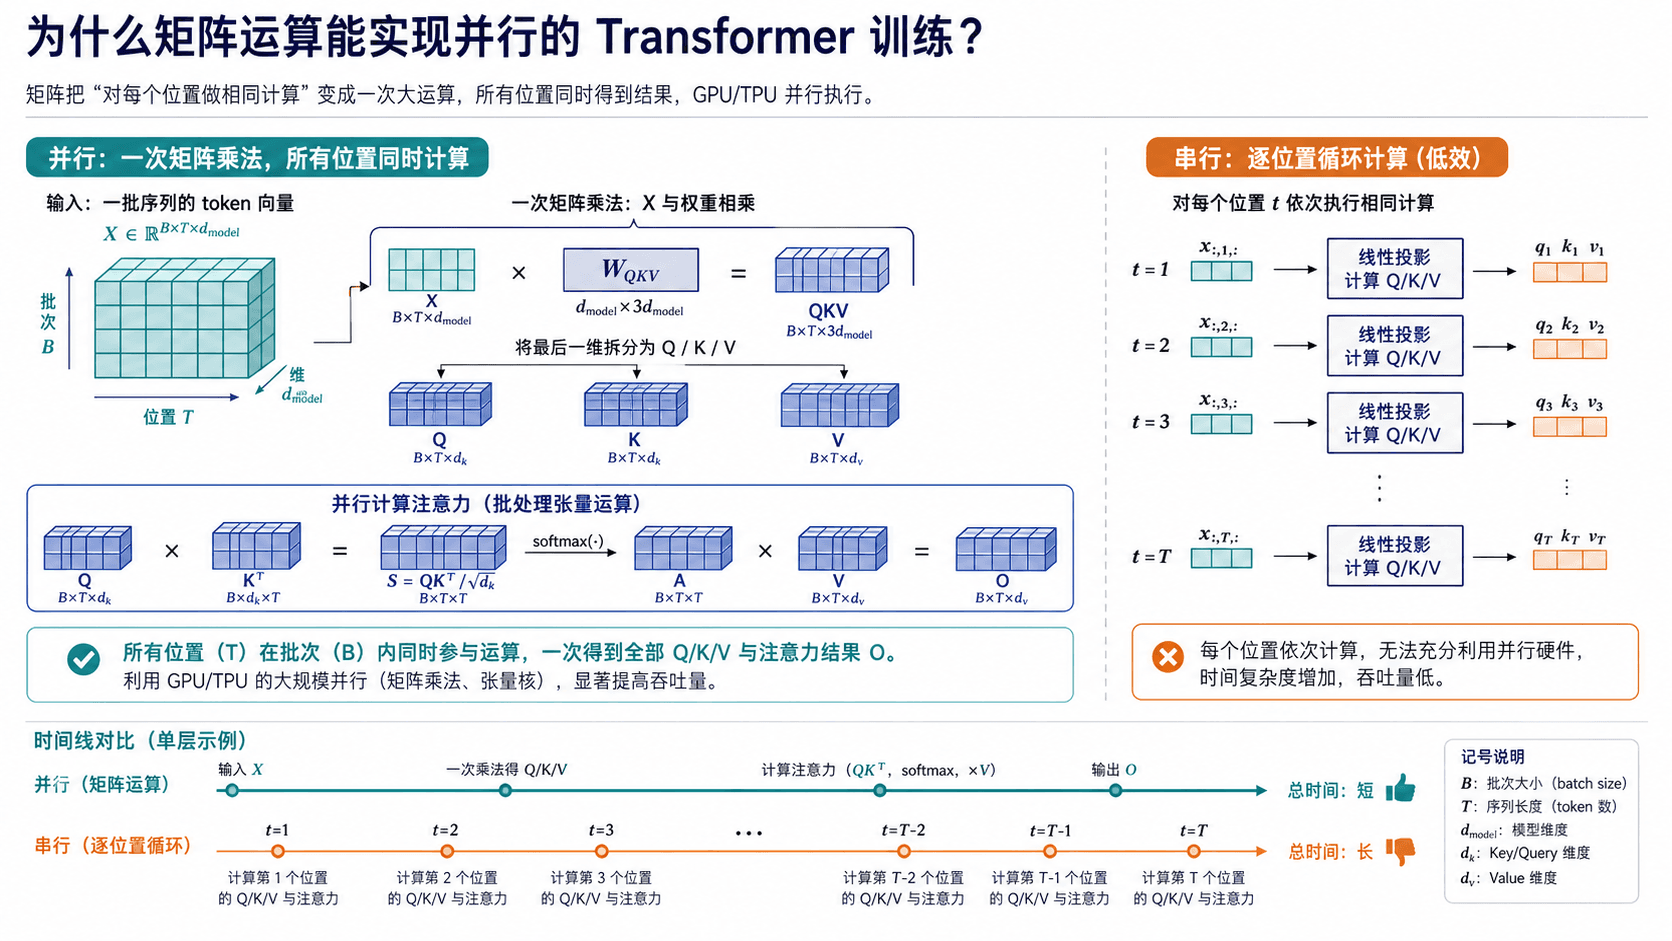
矩阵形式一次处理一个批次中的所有位置,逐位置循环则要重复相同投影和注意力步骤,难以充分利用并行硬件。
矩阵化和并行训练不是完全相同的概念
矩阵化是把许多相同类型的运算组织成矩阵乘法,并行训练则是训练阶段可以同时处理多个序列位置。二者紧密相关,但不能完全画等号。即使写成矩阵形式,如果存在必须等待前一步结果的依赖,仍然可能无法充分并行。
Transformer 的解码器在训练时可以利用右移目标序列和因果掩码,一次计算所有位置;推理时却必须根据已经生成的 token 继续向后走。矩阵化仍然用于每一步内部的计算,但生成步骤之间的依赖无法消除。
因此,更准确的说法是:矩阵化让每一个可并行的计算阶段更高效,掩码和目标构造决定哪些位置可以同时计算,训练与推理的输入条件则决定整个流程能否并行。
多头注意力如何沿用矩阵形式
多头注意力并不会回到逐词循环。输入 X 经过多组投影,得到每个头自己的 Q、K、V,再在每个头内部执行相同的矩阵注意力计算。实现时通常把头维度加入张量,让多个头一起进行批量矩阵乘法。
每个头会得到一个 [n, d_v] 的输出,所有头的结果沿最后一维拼接,再通过输出投影回到 d_model。文中所说的“不同线性变换、分别计算 Attention、拼接并再次线性变换”,都可以用矩阵批量运算完成。
多头带来的是多个表示子空间,矩阵化带来的是统一的计算组织。前者让模型同时关注不同关系,后者让这些关系能够在硬件上并行处理。
如何检查矩阵公式是否写对
先检查形状:X 是 [n, d_model],Q/K 是 [n, d_k],V 是 [n, d_v],QK^T 是 [n, n],Softmax 后的权重仍是 [n, n],最后乘 V 得到 [n, d_v]。任何一步的内维对不上,都说明转置或维度定义有问题。
再检查含义:QK^T 的行是 Query,列是 Key;Softmax 通常沿 Key 位置归一化;Padding Mask 和 Sequence Mask 应该作用在分数矩阵上;AV 的每一行应该对应一个 Query 位置的上下文输出。
最后用一个很短的序列手算验证。取 n = 3,只保留几个简单数值,分别计算一个位置的逐词结果和矩阵结果,确认二者一致。小例子比直接查看大张量更容易发现转置、Softmax 轴或 Mask 位置错误。
把矩阵化 Self-Attention 放回主线
Transformer 先把序列表示组成矩阵 X,再通过 XW_Q、XW_K、XW_V 同时生成所有位置的 Q、K、V。QK^T 一次得到所有 Query-Key 分数,缩放和掩码后通过 Softmax 形成注意力矩阵,最后用 AV 一次得到所有位置的上下文输出。
这条矩阵路径与逐词公式完全对应:每一行代表一个位置,每一列代表一个候选关注位置,矩阵乘法把大量相同的小操作打包成适合并行硬件执行的大操作。
也要记住它的边界:矩阵化提高了计算效率,却没有改变注意力的平方级位置关系成本;训练可以并行,不代表自回归推理可以一次生成整句。理解这些边界,才能既看到 Transformer 的优势,也知道它在长序列和生成阶段的代价。
常见问题
矩阵计算和逐词计算得到的结果一样吗?
在运算顺序和数值精度一致的情况下,二者表达的是同一个自注意力公式。矩阵计算只是把多个位置的相同操作组织成批量矩阵运算。
矩阵化会不会解决注意力的平方复杂度?
不会。矩阵化更适合硬件并行,可以提高实际吞吐,但 QK^T 仍然产生 [seq, seq] 矩阵,序列变长时计算和显存开销仍会增长。
推理阶段还能使用矩阵计算吗?
可以。每一步生成内部仍然使用矩阵运算,只是下一步输入依赖当前生成结果,所以整个目标序列不能像训练时那样一次并行生成。