
Transformer 如何把隐藏状态变成词:Linear、Softmax 与词表概率
从解码器最后的隐藏状态出发,解释线性层如何生成词表 logits,Softmax 如何得到概率分布,以及模型如何选择下一个 token。
相关工具
文章目录(11 个章节)
解码器最后输出的还不是一个词
Transformer 解码器每一层都在处理向量。到了最后一层,当前位置得到的是一个隐藏状态向量,它包含当前上下文下的语义和位置信息,但还不能直接写成“机器”“学习”或其他词。这个向量更像是模型对当前生成位置的综合判断,真正的词还需要经过输出层。
文中把这一步描述得很直接:解码器栈输出的是一个 float 向量,模型需要通过线性层和 Softmax 层把它转换成词。线性层负责把表示变换到词表维度,Softmax 负责把每个词的分数整理成概率分布。
因此,理解 Transformer 的输出,不能只看注意力矩阵或最后的隐藏状态。还要继续追踪最后一个位置的向量如何经过投影、归一化和解码策略,最终变成一个 token。
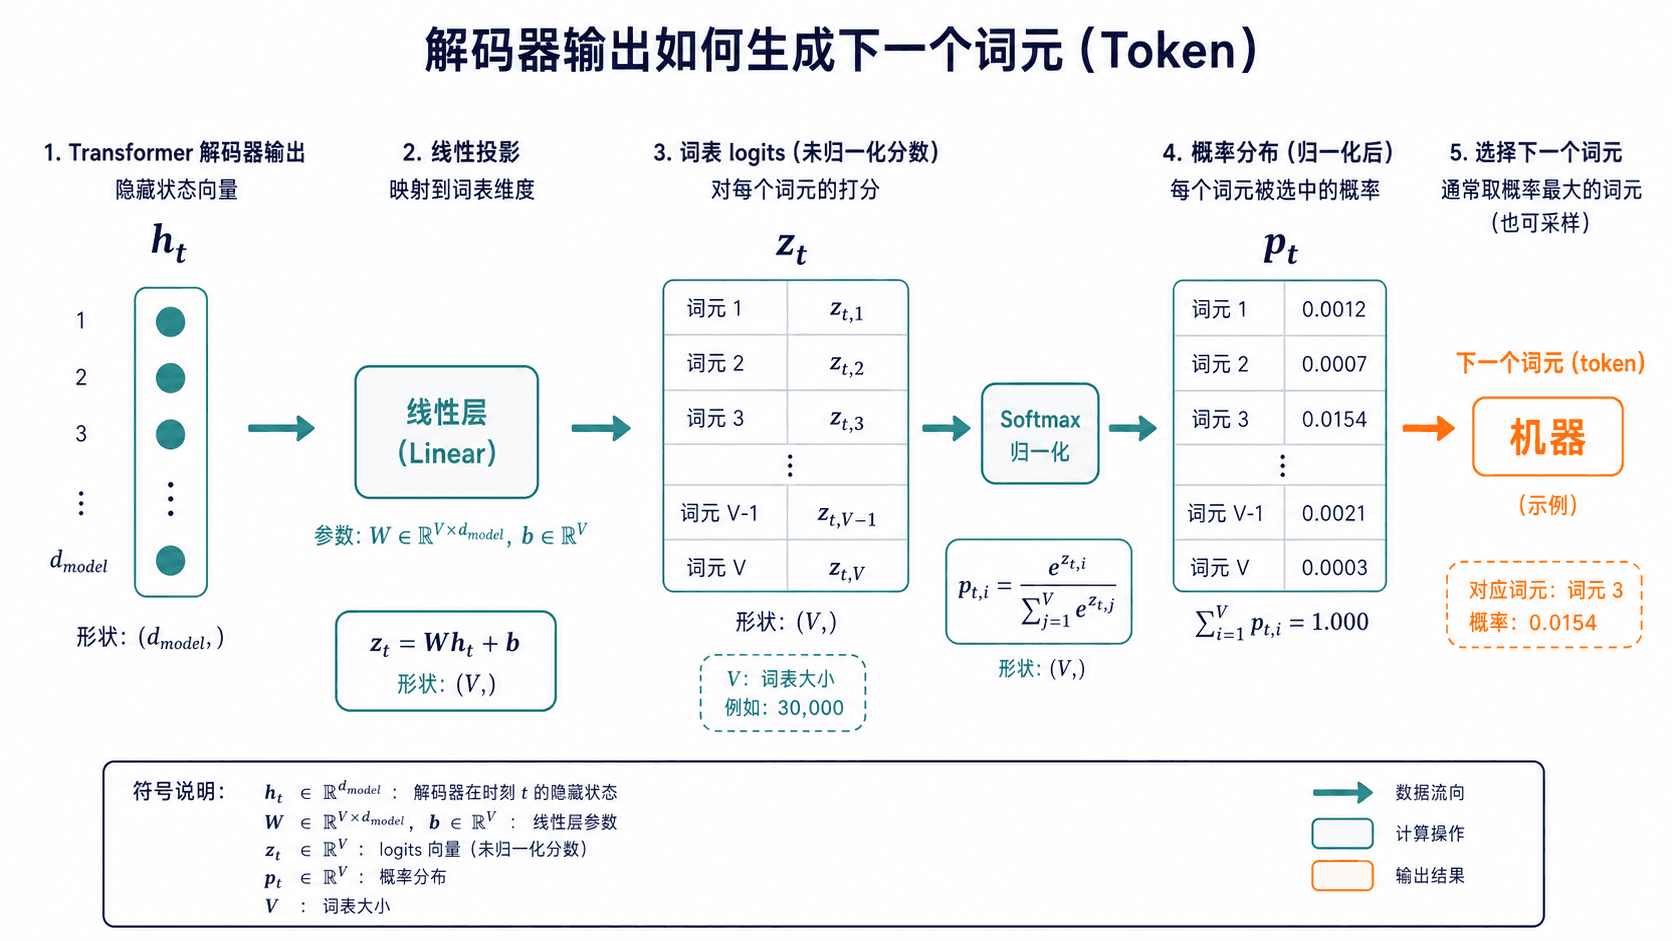
解码器输出依次经过线性投影、词表 logits、Softmax 概率分布和解码选择。
线性层为什么要映射到词表大小
设解码器在某个位置输出的隐藏状态维度是 d_model,词表中有 V 个 token。线性层可以写成 z = Wh + b,其中 h 是 d_model 维隐藏状态,W 的输出维度是 V,最终得到一个长度为 V 的向量 z。这个向量的每一项对应词表中的一个 token。
例如词表有一万个词,线性层就会产生一万个数。第 1 个数是词表第 1 个 token 的分数,第 2 个数对应第 2 个 token,依此类推。它们还不是概率,可以是正数、负数或相差很大的任意实数,所以通常称为 logits。
词表越大,输出投影的参数量和计算量也越大。这是语言模型输出层经常成为计算瓶颈的原因之一。模型前面花大量计算得到一个上下文向量,最后还要把它与整个词表建立对应关系。
logits 和概率不是一回事
logits 可以理解为模型对候选 token 的原始打分。分数高,表示模型更倾向于选择;分数低,表示当前上下文下不太可能。但原始分数没有统一范围,也不满足非负和总和为 1,不能直接当作概率解释。
Softmax 会把一组 logits 转换成概率。它先对每个分数做指数变换,再除以所有指数值的总和,得到 0 到 1 之间的数,并且整组概率相加等于 1。分数之间的相对差异会被保留下来,较高的 logits 通常会对应较大的概率。
需要注意的是,Softmax 只负责形成分布,不负责决定最终输出。模型得到的是“每个候选词各有多大可能”,至于最后选一个、选多个,还是按概率随机采样,则由后面的解码策略决定。
Softmax 在 Transformer 里有两种常见用法
读到 Softmax 时,最容易产生的误解是把注意力里的 Softmax 和输出层里的 Softmax 当成同一件事。它们使用的是同一个数学函数,但归一化的维度和解释完全不同。
在注意力机制中,Softmax 作用于 QK 分数,通常沿着被关注的位置归一化。一行权重加起来等于 1,表示当前查询位置应该把注意力分配给哪些输入位置。它回答的是“我应该看哪里”。
在输出层中,Softmax 作用于词表 logits,沿着词表维度归一化。整组词的概率加起来等于 1,表示下一个 token 在各个候选词之间如何分布。它回答的是“下一个可能是什么”。
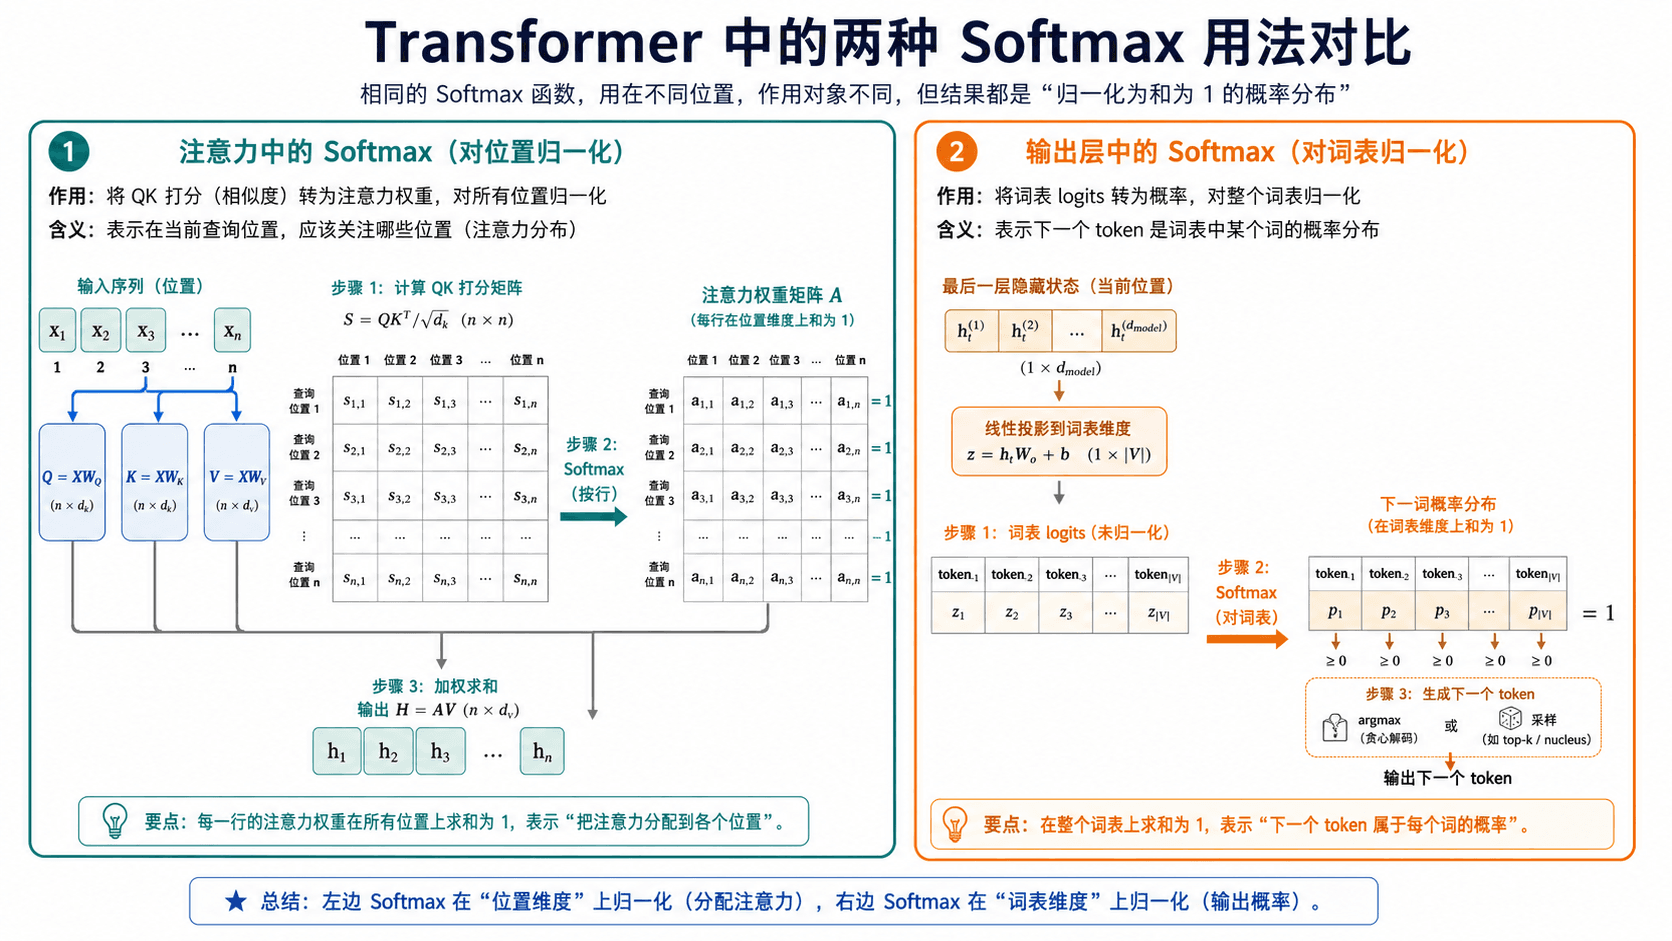
左侧在位置维度分配注意力,右侧在词表维度生成下一个 token 的概率。
为什么最高概率词不一定总是好答案
最简单的解码方式是贪心选择,也就是每一步都取概率最大的 token。这种方法速度快、结果稳定,适合需要确定性输出的场景。但它只看当前一步的最大值,不会回头比较一整段序列的整体质量。
有时一个概率略低的词会让后续句子更自然。如果每一步都只取最高概率,模型可能过早进入一条局部最优的路径,出现重复、句式僵硬或提前结束。解码策略的任务,就是在模型给出的分布上做选择,而不是重新训练模型。
这也是“模型概率高”与“人读起来合理”不能完全画等号的原因。概率是模型在当前上下文中的统计判断,最终质量还会受到上下文长度、训练数据、任务约束以及生成策略的影响。
温度如何改变概率分布
温度通常记作 T,用来调整 logits 在 Softmax 前的尖锐程度。计算上,可以先把 logits 除以 T,再进行 Softmax。T 小于 1 时,分布会更集中,最高分候选更容易被选中;T 大于 1 时,分布会更平,其他候选获得的机会增加。
温度不是简单的“创造力开关”。它改变的是候选分布的相对差异:低温让模型更确定,高温让模型保留更多可能性。如果原始 logits 本身已经不合理,调高或调低温度都不能替代数据、训练目标和模型能力。
实际使用时,温度需要和采样策略一起看。高温加完全随机采样可能让输出过于发散,低温加贪心则可能让文本变得重复。合适的设置取决于任务是需要稳定复现,还是需要保留一定的表达变化。
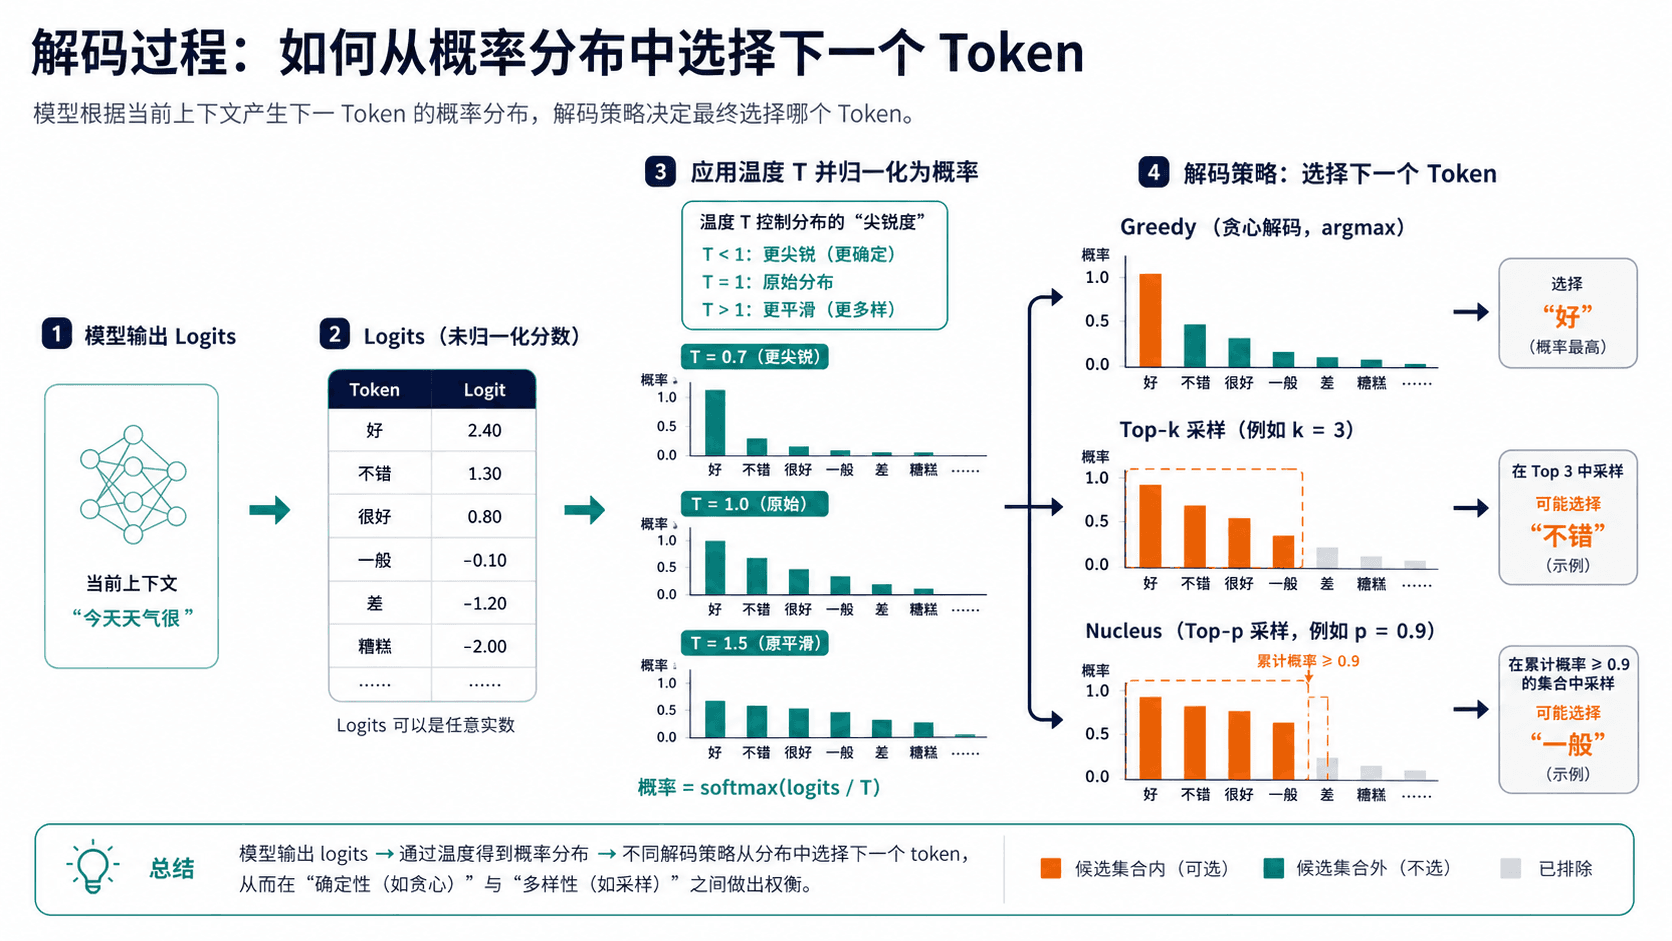
温度改变概率分布的尖锐程度,贪心、Top-k 和 Top-p 再从候选集合中做不同选择。
Top-k 和 Top-p 在限制什么
Top-k 只保留概率最高的 k 个候选词,再对这些候选重新归一化并采样。这样可以排除长尾中非常不可能的词,同时保留多个高概率选项。k 太小,输出会接近贪心选择;k 太大,过滤作用会变弱。
Top-p 又叫核采样,它不是固定保留多少个词,而是从高概率候选开始累加,直到累计概率达到 p。分布集中时,候选集合会自动变小;分布平坦时,集合会扩大。它对不同上下文的适应性通常比固定 k 更强。
两种策略都发生在概率分布形成之后。它们不会改变 Transformer 的隐藏状态,也不会改变线性层产生的 logits,只是在“模型认为哪些词可能”之后,对实际抽取范围做约束。
训练时如何使用这些分数
训练阶段通常不会先选出一个词,再根据这个词更新模型。模型会在每个有效位置产生完整的 logits 向量,随后与真实标签计算交叉熵。交叉熵会推动正确 token 的分数上升,同时相对压低其他候选的分数。
这也是为什么训练时需要保留完整词表分数,而推理时才执行贪心、Top-k 或 Top-p。训练的目标是让整个分布更接近数据中的目标分布,推理的目标是从这个分布中生成一条可用的序列。
如果使用了 Label Smoothing,训练目标不再是把正确词概率推到绝对的 1,而是让正确词占主要概率、其他词保留少量质量。它会影响输出分布的尖锐程度,但不改变线性层和 Softmax 的基本流程。
输出层参数为什么可能很大
输出投影矩阵的形状大致是词表大小乘以模型隐藏维度。词表从一万扩大到十万时,即使隐藏维度不变,矩阵参数也会明显增加。对于大模型来说,最后的词表投影不仅占参数,还会带来可观的矩阵乘法和 Softmax 成本。
有些模型会让输入词嵌入矩阵和输出投影共享参数,借此减少参数量并让输入、输出词表示处于相近的空间。是否共享取决于模型结构和训练设计,不能把它当成所有 Transformer 的固定规定。
词表设计也会影响输出。分词器把文本拆成 token,输出层选择的也是 token,而不一定是完整汉字或完整单词。看到生成结果时,一个词可能由多个 token 组成,模型实际上是在多个时间步逐段完成它。
从隐藏状态到 token 的完整检查顺序
第一步看形状:隐藏状态最后一维应是 d_model,线性投影后的最后一维应是词表大小。第二步看数值:logits 可以为负,也不要求相加等于 1;经过 Softmax 后,概率应为非负,沿词表维度的总和应接近 1。
第三步看位置:训练时每个位置的 logits 都应该与右移后的标签对应,不能把整个序列只拿最后一个位置计算损失。第四步看解码:确认使用的是贪心、温度采样、Top-k 还是 Top-p,并记录这些设置,否则同一个模型可能得到难以比较的结果。
如果输出完全重复,先检查解码策略和概率分布是否过于尖锐;如果输出跳跃很大,先检查温度、采样范围和上下文是否稳定;如果训练损失正常但生成异常,再回到标签偏移、特殊 token 和 Padding 的检查。
把输出层放回 Transformer 主线
Transformer 的前面部分负责把上下文组织成隐藏状态,最后的输出层负责把这个状态翻译回词表空间。线性层完成维度映射,得到每个 token 的原始分数;Softmax 把分数变成概率;解码策略根据任务需要从概率分布中选择下一个 token。
这条路径也解释了为什么一个看似简单的“输出一个词”,背后包含了表示、词表和选择三个层次。模型不是直接从隐藏状态里拿出一个单词,而是先为词表中的每个 token 打分,再把整组分数转换成可比较的概率。
理解这一步之后,再去看温度、Top-k、Top-p、重复惩罚或 Beam Search,就能知道它们分别作用于哪里:有的改变分布,有的裁剪候选,有的维护多条序列。它们都建立在同一个输出投影和词表概率之上。
常见问题
logits 为什么不能直接当概率?
logits 是线性层产生的原始分数,可以为负,也不要求总和为 1。Softmax 会把它们转换成非负且总和为 1 的概率分布。
注意力里的 Softmax 和输出层 Softmax 有什么区别?
注意力里的 Softmax 在位置维度上归一化,用来分配关注位置;输出层的 Softmax 在词表维度上归一化,用来表示下一个 token 的概率。
温度越高,输出一定越好玩吗?
不一定。温度越高通常会让分布更平、候选更多,但也可能增加不稳定和跑题。它需要结合任务目标、采样范围和上下文质量一起调整。